Помогите своему приложению Solana работать быстрее: проверьте объём данных gRPC, обработку при приёме и ресурсы среды выполнения
Приложение Solana, которое вы разрабатываете, может работать быстрее. Объём получаемых данных, последующая обработка и ресурсы, в том числе CPU и сеть, влияют на результат совместно. Пересмотр этого сочетания может помочь лучше раскрыть производительность уже созданного программного обеспечения.
Вы начали разрабатывать систему HFT на Solana, подключились к Geyser gRPC и видите данные в логах. Но решения принимаются не так быстро, как ожидалось. Ожидание между получением данных и принятием решения может подсказать, где искать улучшения. Начните с того, что можно наблюдать в текущем коде.
В ERPC обсуждения и обратная связь от клиентов дают нам возможность пересматривать доставку данных, настройки приёма и обработку в приложениях. Эти наблюдения помогают улучшать нашу доставку и документацию. В статье мы объясняем механизмы и шаги исследования, чтобы разработчики, впервые работающие с быстрыми потоками большого объёма, могли искать возможности улучшения в своей среде.
Начните с одной небольшой проверки текущего кода
Технические термины и диагностические команды можно изучать по мере необходимости. Если у вас есть ИИ-агент, который может читать код проекта, сначала попробуйте передать ему короткий запрос ниже. Добавьте, где работает приложение и в каких ситуациях оно кажется медленным. Неопределённые требования и недоступные измерения можно пока оставить как есть и начать с доступных наблюдений.
text
Хочу понять, есть ли у моего приложения Solana возможность отвечать быстрее.
Сначала прочитай текущий код и найди точку получения данных и точку завершения принятия решения с использованием этих данных. Сохрани текущую подписку и предложи минимальное изменение для измерения числа событий и прошедшего времени на этом участке.
В рамках этой первой задачи покажи точки измерения, предлагаемое изменение, что оно позволит узнать и что останется неизмеренным. Если доступа к хосту нет, начни с наблюдений внутри приложения. Не раскрывай секреты, не меняй рабочую среду production и не создавай платные ресурсы.
Хочу понять, есть ли у моего приложения Solana возможность отвечать быстрее.
Сначала прочитай текущий код и найди точку получения данных и точку завершения принятия решения с использованием этих данных. Сохрани текущую подписку и предложи минимальное изменение для измерения числа событий и прошедшего времени на этом участке.
В рамках этой первой задачи покажи точки измерения, предлагаемое изменение, что оно позволит узнать и что останется неизмеренным. Если доступа к хосту нет, начни с наблюдений внутри приложения. Не раскрывай секреты, не меняй рабочую среду production и не создавай платные ресурсы.Первый полезный результат: понять, где и что измерять в собственном коде. Разделив наблюдаемые и пока не измеренные участки, проще выбрать следующий предмет исследования. Далее в статье приведён более подробный запрос для углублённой диагностики.
Например, агент может ответить: «Данные принимаются в
onData файла stream.ts, а принятие решения завершается в onDecisionComplete файла strategy.ts. Предлагаю изменение для агрегирования числа полученных событий, числа принятых решений и времени, прошедшего на этом участке. В этой схеме измерения участок до callback находится вне области измерения». В этом примере ответа используются вымышленные имена файлов и функций TypeScript. Независимо от языка программирования проверьте, что реальные места в коде, записи, которые нужно добавить, и ограничения этого измерения согласованы. Если получение данных и принятие решений не связаны один к одному, попросите агента также предложить их соответствие и единицу подсчёта.Дополните опыт веб-разработки взглядом на непрерывный поток
Управляемые сервисы позволяют создавать многие веб-функции, не погружаясь в устройство каждого серверного компонента. Этот опыт остаётся основой и при работе с потоками Solana. Дополните его наблюдением за тем, сколько данных поступает непрерывно и как быстро приложение их обрабатывает.
Подключение к Solana через SDK может выглядеть столь же простым. Но подписка на широкий набор транзакций или обновлений аккаунтов меняет нагрузку. Требования к пропускной способности, CPU и памяти зависят от подписки, размеров сообщений, сжатия, обработки в приложении и текущего трафика. Единого фиксированного числа мегабайт в секунду для «Solana» не существует.
Начать стоит с того, чтобы сделать соотношение входящей работы и возможностей обработки предметом проектирования и измерений.
Поток продолжает идти, а очередь может расти
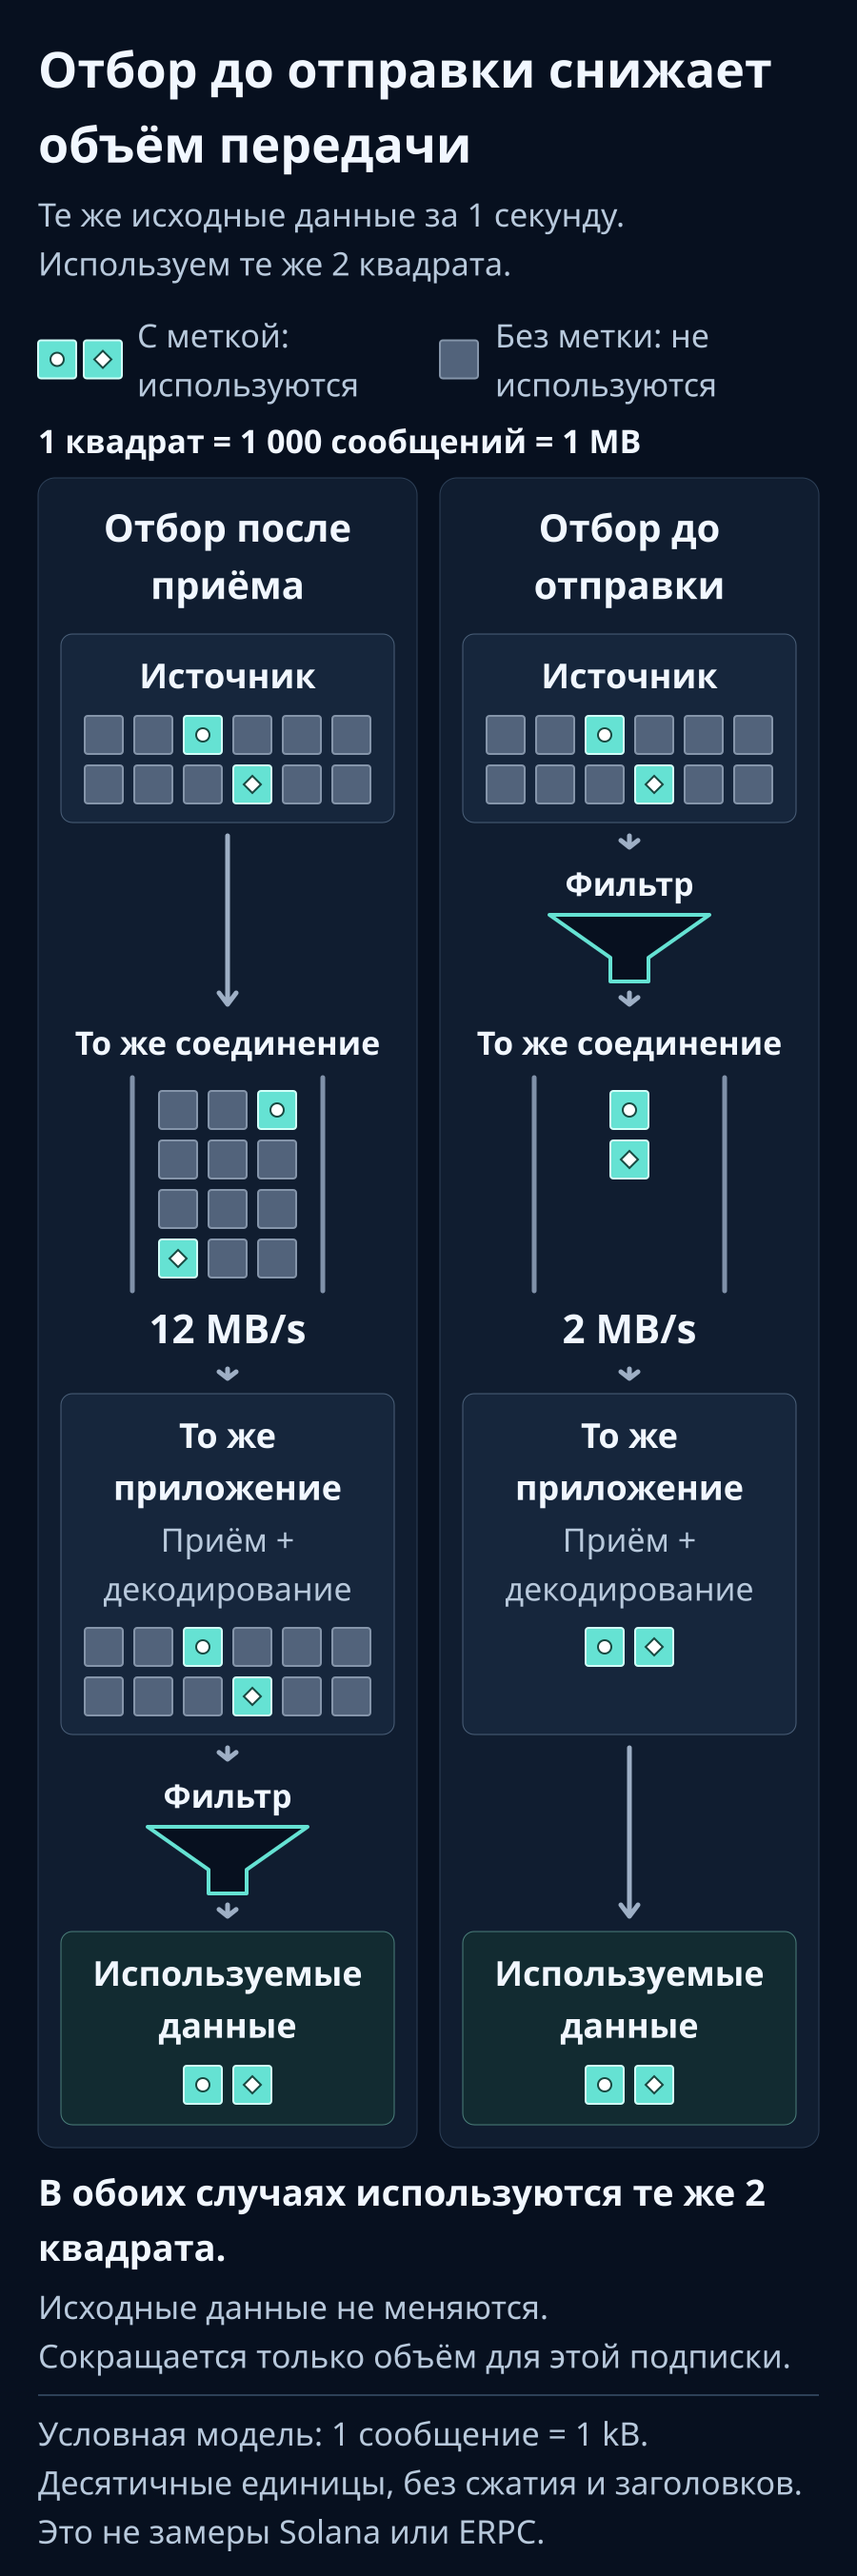
Сначала сравним данные, поступающие за одну и ту же секунду, с помощью квадратов одинакового размера. Каждый квадрат означает 1 000 сообщений; если принять размер сообщения за 1 kB, в сумме получается 1 MB. В примере с меньшим объёмом приложение получает 2 MB в секунду, с большим объёмом получает 12 MB в секунду, а производительность принимающего приложения в обоих случаях одинакова. Это модель для пояснения объёма полезной нагрузки сообщений в десятичных единицах, без учёта сжатия и заголовков протокола.
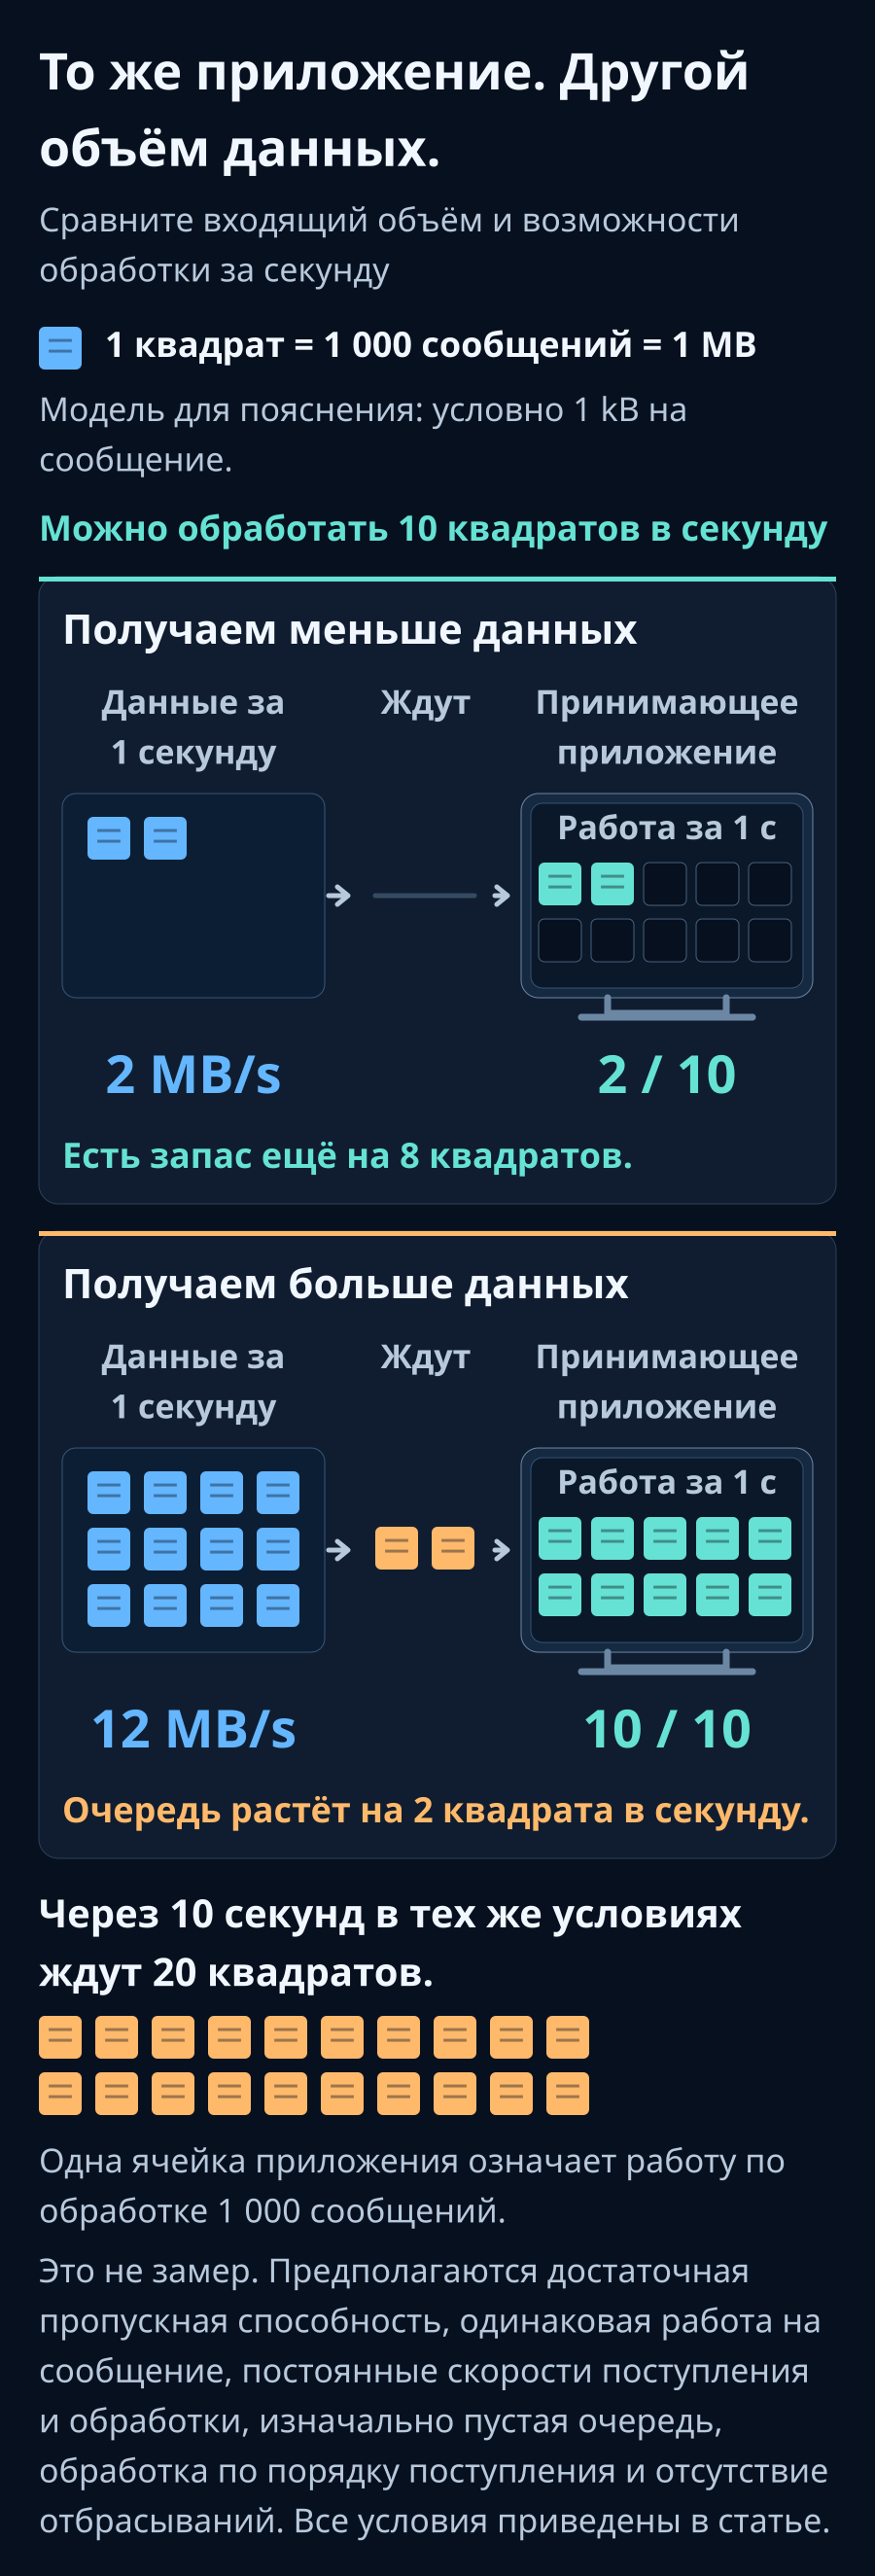
Рассмотрим условную модель: каждую секунду приходят 12 000 событий, а компьютер способен обработать 10 000. Каждое событие требует одинакового объёма работы, начальная очередь пуста, обработка идёт в порядке поступления, и ни одно событие не отбрасывается.
Каждую секунду добавляются ещё 2 000 необработанных событий. Через десять секунд в очереди ждут 20 000 событий. Событие, вставшее в очередь в этот момент, будет ждать начала обработки примерно две секунды. Логи продолжают обновляться, а очередь продолжает расти.
Это допущения для объяснения, а не измерения Solana или ERPC. В модели входящий поток и производительность постоянны. В реальности трафик приходит всплесками, а затраты на обработку различаются, поэтому ожидание возможно даже при достаточной средней производительности.
Управление потоком gRPC подстраивает передачу под объём, который может принять получатель. Если обработка отстаёт, ожидание может выйти за пределы очереди приложения и затронуть коммуникационные библиотеки или отправителя. Работающее соединение или успешная запись через API отправки не показывают, насколько свежими будут данные в момент получения.[1]
Выберите нужные данные до передачи по сети
Если для решений нужны только определённые программы или аккаунты, сначала определите необходимые данные и примените серверные фильтры подписки. Yellowstone gRPC поддерживает фильтры транзакций и аккаунтов. Допустимые сочетания условий и доступный охват проверяйте по спецификации используемых API, SDK и сервиса.[2]
Если пока неясно, что фильтровать, найдите в коде значения, которые приложение использует для принятия решений, и поля уведомлений, из которых они получаются. На основе этого соответствия составьте варианты условий подписки, затем проверьте, что известные необходимые события остаются включены. Проверка и сокращения числа событий, и сохранения нужных данных создаёт основу для следующего сравнения.
Если сначала получить всё, а затем отбросить ненужное на клиенте, передача, расшифровка и декодирование до этой точки уже выполнятся. Фильтрация у отправителя позволяет сократить эти затраты. В приведённом примере сужение входящего потока до необходимых 2 000 событий в секунду оставляет запас при той же производительности 10 000 событий в секунду.
Представьте дорожное движение: длина дороги соответствует расстоянию распространения сигнала, полосы движения соответствуют пропускной способности, пункт оплаты соответствует мощности приёма, а ряд машин соответствует ожидающей работе. Если направить через один и тот же пункт только нужные машины, очередь будет отличаться от той, что возникнет при направлении туда всех машин поблизости. Сокращение дороги и уменьшение числа машин решают разные задачи.
У связи есть и физические пределы. Передача 100 MB со скоростью 1 Gbps теоретически занимает не менее 0,8 секунды, а при 10 Gbps требует 0,08 секунды. Это нижние границы в десятичных единицах, без учёта расстояния, накладных расходов протокола, повторных передач и очередей. Они не означают, что каждое отдельное событие в потоке задерживается на 0,8 секунды.
Даже если одна вычислительная операция быстрее сетевого обмена, передача ненужных данных всё равно имеет цену. Нужно отдельно учитывать время распространения сигнала, объём, проходящий через канал за единицу времени, и объём работы, который можно завершить после получения.
Некоторым приложениям, включая полные индексы, аудит и исследования, нужны все данные. Для такой нагрузки необходимы соответствующие возможности приёма, обработки и хранения. Получение всех отдельных уведомлений также отличается от ожидания полного блока, то есть данных, агрегированных и восстановленных в виде блока. Проверьте, не зависит ли ваше решение без необходимости от посторонних данных или завершения агрегации.[2]
Проверьте обработку при приёме и ресурсы среды выполнения
Rust помогает снизить затраты на обработку. Чтобы использовать это преимущество, также изучите входящий объём, эффективную пропускную способность соединения, ожидание записи в базу данных, блокировки и последовательные участки. В асинхронной среде правильное размещение вычислительно интенсивной работы и работы, блокирующей поток выполнения, тоже может улучшить приложение.[3]
Держите цикл приёма коротким и выносите дорогую обработку отдельно. Задайте предел очереди и поведение при её заполнении. Неограниченная очередь может скрывать рост задержки за ростом потребления памяти. Ограниченная очередь тоже не устраняет постоянную нехватку производительности. Сохраняя необходимый порядок и полноту данных, выбирайте сокращение подписки, более эффективную обработку, разделение работы, параллелизм или дополнительные ресурсы.
Сначала измерьте путь от получения данных до завершения принятия решения, затем подробнее исследуйте места, где возникает ожидание. Таблица подсказывает, с чего начать в каждой области. Подробные названия метрик и команды также включены в диагностический запрос ниже, поэтому к ним можно обращаться по мере необходимости.
| Ресурс | Что проверить сначала |
|---|---|
| CPU | Не сосредоточена ли работа на одном ядре? Проверьте общую загрузку и загрузку отдельных ядер, а также ограничения CPU в среде выполнения |
| Память | Продолжают ли расти число ожидающих событий или использование памяти? Сопоставьте объём данных в очереди со временем ожидания самого старого события |
| Диск и база данных | Не ждёт ли приём завершения сохранения? Проверьте запись в базу данных и ожидание хранилища. Если приложение не сохраняет данные, можно начать с других областей |
| Сеть | Соответствуют ли канал и его настройки входящему объёму? Проверьте фактическую скорость передачи, время кругового прохода и повторные передачи |
При более подробном исследовании связи настройки библиотек тоже могут дать подсказки. В HTTP/2 окна управления потоком существуют на уровне потока и соединения и определяют, сколько дополнительных данных может отправить другая сторона. Если этот объём мал относительно произведения пропускной способности на задержку, то есть пропускной способности, умноженной на время кругового прохода, скорость передачи может достичь потолка даже при запасе канала. В соответствующей ситуации проверьте библиотеку и промежуточные устройства, уточняя область действия настройки и расход памяти при её изменении.[4]
Помимо приёма, измеряйте свежесть данных и ожидание
Чтобы начать проверку накопления работы внутри приложения, сохраните текущую подписку и за один и тот же период наблюдения запишите число полученных и обработанных событий, длину очереди и время ожидания самого старого события. Если не знаете, где измерять, попросите агента изучить код с помощью запроса ниже. Если явной очереди нет, начните со времени от получения данных до завершения принятия решения и сравните его с диагностическим вариантом без ресурсоёмкой обработки.
Этот псевдокод, не привязанный к языку или SDK, показывает, куда добавить измерения. При добавлении наблюдений в реальный код сохраняйте существующие порядок обработки и степень конкурентного выполнения.
text
При получении данных:
  Увеличить счётчик полученных событий на 1
  Записать монотонную отметку времени приёма, связанную с этим событием
  Передать данные в существующую обработку

Когда завершено принятие решения с использованием того же события:
  Увеличить счётчик завершённых событий на 1
  Вычислить и агрегировать время, прошедшее с момента приёма
При получении данных:
Увеличить счётчик полученных событий на 1
Записать монотонную отметку времени приёма, связанную с этим событием
Передать данные в существующую обработку
Когда завершено принятие решения с использованием того же события:
Увеличить счётчик завершённых событий на 1
Вычислить и агрегировать время, прошедшее с момента приёмаЕсли получение данных и решения не связаны отношением один к одному, сначала определите их соответствие и единицу подсчёта. Агрегирование наблюдений за фиксированный интервал позволяет сравнивать результаты без добавления сообщения в лог для каждого события.
Для дальнейшей диагностики также записывайте полученные байты, объём очереди в байтах, p50/p95/p99 времени обработки, ошибки и переподключения. p99 означает порог, не превышаемый в 99% измеренных значений времени обработки. Указывайте точки измерения. Трафик NIC, размер Protobuf и размер декодированных объектов представляют разные величины.
Для интервалов на одном хосте используйте монотонные часы, отдельно отмечая получение, постановку в очередь, извлечение и завершение. Если декодирование уже завершилось к вызову callback SDK, участок до callback остаётся неизмеренным. При сравнении с меткой времени отправителя проверьте синхронизацию часов и место создания метки. Не называйте полученную разницу чистой сетевой задержкой автоматически.
Если при неизменной подписке ожидание уменьшается после удаления бизнес-обработки, это повод исследовать влияние её добавления. Одна лишь быстрая работа после callback не доказывает, что данные пришли свежими.
Можно также сравнивать идентификаторы событий с эталонным потоком при тех же подписке и commitment (стадии подтверждения используемых данных). Убедитесь, что в самом эталонном потоке не накапливается очередь. Одна лишь разница в slot не доказывает потери данных и не переводится в фиксированное число секунд: в некоторых slot нет подходящих событий, а некоторые slot могут быть пропущены.[5]
mtr помогает изучать задержки маршрута и характер ответов. Потери только на промежуточном hop могут быть следствием ограничения ответов самим маршрутизатором. Сопоставляйте поведение до конечного адресата с повторными передачами TCP, фактической скоростью и другим маршрутом. Одного mtr недостаточно, чтобы установить исчерпание полосы или неисправность дата-центра.[6]
Диагностический запрос для ИИ-агента
Передайте следующий текст агенту, который может читать код вашего проекта. Сначала укажите, где он запускается и в какой ситуации что именно кажется медленным. Агент сможет начать с изучения подключения, подписки и обработки после получения данных по коду. Вставлять API-ключи или учётные данные в разговор не требуется.
Если необходимые события или допустимая задержка ещё не определены, так и скажите. Своими словами объясните, какую информацию хотите наблюдать и какие решения принимать. Недоступные показатели оставьте отмеченными как неизмеренные и начните с того, что можно проверить сейчас.
text
Исследуй, есть ли у моего клиента Solana Geyser gRPC возможность отвечать быстрее. Если есть задержки, накопление очереди или разрывы соединения, установи их причины и помоги улучшить ситуацию. Не считай успешное подключение или события в логах доказательством обработки актуальных данных. Не решай заранее, что причина находится на стороне клиента или провайдера.

1. Определи цель: необходимые события, допустимую свежесть, требования к порядку и потерям, фильтры подписки, commitment, регион endpoint, фактические версии языка/SDK/gRPC-библиотеки и среду выполнения. Сначала просмотри доступный код, конфигурацию и lockfile; спрашивай только недостающую информацию. Неопределённые требования явно оставь неопределёнными и сначала изучи текущее состояние. Не показывай секреты, а в передаваемых логах скрывай чувствительные данные.

2. Измерь путь от получения до завершения. В первую очередь изучи получение, завершение обработки и время ожидания, начиная с доступных измерений. Запиши события/с, байты/с, завершённые события/с, число/байты событий в очереди/ожидание самого старого события, p50/p95/p99, ошибки, разрывы, переподключения и сбросы. Если явной очереди нет, сообщи об этом и укажи участки обработки, которые можно наблюдать. Укажи точки наблюдения и неизмеренные интервалы. Различай трафик NIC, байты в канале, размер Protobuf и декодированные объекты. Для локальных интервалов используй монотонные часы; для внешних временных меток проверь синхронизацию и место их создания. Не трактуй разницу в slot напрямую как потерю данных или фиксированную длительность.

3. Раздели ограничения CPU, памяти, диска и сети. Проверь CPU по ядрам/потокам, steal и лимиты CPU, RSS/GC/swap/PSI, ожидание I/O, байты/сбросы/ошибки NIC, повторные передачи TCP и RTT. Среди подходящих Linux-инструментов есть mpstat, pidstat, vmstat, iostat, sar, ss -ti и /proc/pressure/. Если инструментов или прав нет, сообщи об этом и предложи минимально необходимые команды. Если доступа к хосту нет, поищи информацию в панели управления или в измерениях внутри приложения, а недоступные показатели отметь как неизмеренные. Не выдумывай результаты.

4. Проверь окна HTTP/2 на уровнях потока и соединения, буферы приёма TCP, прокси, VPN и sidecar. Обратись к официальной документации установленной версии SDK и учти произведение пропускной способности на задержку. Проверь преобразования JSON, логирование каждого события, синхронные вызовы базы данных/внешних API, блокирующие операции, блокировки, неограниченное создание задач и неограниченные очереди внутри и рядом с циклом приёма. Не считай сам по себе Rust или асинхронный код решением.

5. Если доступен mtr или аналог, выполни конечное число измерений к реальному хосту endpoint. На поддерживаемых системах можно рассмотреть команду: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Используй фактический порт, не предполагая стандартный порт TLS. Не объявляй неисправность только по потерям промежуточного hop; сравни поведение конечного адресата, повторные передачи и другие маршруты. Не заменяй измерение пропускной способности результатами mtr.

6. Запиши исходные показатели при текущей подписке и меняй по одному параметру. Сохраняй одну и ту же подписку при сравнении минимального пути приёма с конвейером, включающим бизнес-обработку. Изменения фильтров проверяй отдельно. Перед сужением подписки сопоставь входные данные для решений с уведомлениями и проверь, что предлагаемые фильтры включают известные необходимые события. Спроектируй ограниченные очереди и параллелизм с сохранением требуемого порядка и полноты, явно задав поведение при переполнении. Не отбрасывай необходимые данные без разрешения. Сохраняй полные сведения об ошибках и о том, когда разрешена повторная попытка; не переподключайся в течение предписанной паузы.

7. Отдельно сообщи наблюдаемые факты, возможные причины, непроверенные гипотезы, изменения для проверки и измерения до/после. Оцени CPU, RAM, полосу, производительность хранения и размещение по подписке и измерениям, включая запас для пиков. Не придумывай универсальные фиксированные требования Solana к оборудованию. При необходимости предложи сравнение машин/дата-центров с одинаковыми подпиской, SDK и commitment.

Если я использую ERPC, прочитай актуальный gRPC FAQ и следуй инструкции для конкретного кода ошибки:
https://erpc.global/en/faq/grpc/general/
Если подключён ERPC User MCP или CLI, проверь реально доступные операции и права. Доступ к аккаунту не означает доступ к диагностике хоста. Перед созданием платного VPS, изменением договора, обновлением или перезапуском production покажи стоимость, цель и продолжительность теста и получи моё согласие. Сначала заверши диагностику и подготовь улучшения, которые можно проверить.
Исследуй, есть ли у моего клиента Solana Geyser gRPC возможность отвечать быстрее. Если есть задержки, накопление очереди или разрывы соединения, установи их причины и помоги улучшить ситуацию. Не считай успешное подключение или события в логах доказательством обработки актуальных данных. Не решай заранее, что причина находится на стороне клиента или провайдера.
1. Определи цель: необходимые события, допустимую свежесть, требования к порядку и потерям, фильтры подписки, commitment, регион endpoint, фактические версии языка/SDK/gRPC-библиотеки и среду выполнения. Сначала просмотри доступный код, конфигурацию и lockfile; спрашивай только недостающую информацию. Неопределённые требования явно оставь неопределёнными и сначала изучи текущее состояние. Не показывай секреты, а в передаваемых логах скрывай чувствительные данные.
2. Измерь путь от получения до завершения. В первую очередь изучи получение, завершение обработки и время ожидания, начиная с доступных измерений. Запиши события/с, байты/с, завершённые события/с, число/байты событий в очереди/ожидание самого старого события, p50/p95/p99, ошибки, разрывы, переподключения и сбросы. Если явной очереди нет, сообщи об этом и укажи участки обработки, которые можно наблюдать. Укажи точки наблюдения и неизмеренные интервалы. Различай трафик NIC, байты в канале, размер Protobuf и декодированные объекты. Для локальных интервалов используй монотонные часы; для внешних временных меток проверь синхронизацию и место их создания. Не трактуй разницу в slot напрямую как потерю данных или фиксированную длительность.
3. Раздели ограничения CPU, памяти, диска и сети. Проверь CPU по ядрам/потокам, steal и лимиты CPU, RSS/GC/swap/PSI, ожидание I/O, байты/сбросы/ошибки NIC, повторные передачи TCP и RTT. Среди подходящих Linux-инструментов есть mpstat, pidstat, vmstat, iostat, sar, ss -ti и /proc/pressure/. Если инструментов или прав нет, сообщи об этом и предложи минимально необходимые команды. Если доступа к хосту нет, поищи информацию в панели управления или в измерениях внутри приложения, а недоступные показатели отметь как неизмеренные. Не выдумывай результаты.
4. Проверь окна HTTP/2 на уровнях потока и соединения, буферы приёма TCP, прокси, VPN и sidecar. Обратись к официальной документации установленной версии SDK и учти произведение пропускной способности на задержку. Проверь преобразования JSON, логирование каждого события, синхронные вызовы базы данных/внешних API, блокирующие операции, блокировки, неограниченное создание задач и неограниченные очереди внутри и рядом с циклом приёма. Не считай сам по себе Rust или асинхронный код решением.
5. Если доступен mtr или аналог, выполни конечное число измерений к реальному хосту endpoint. На поддерживаемых системах можно рассмотреть команду: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Используй фактический порт, не предполагая стандартный порт TLS. Не объявляй неисправность только по потерям промежуточного hop; сравни поведение конечного адресата, повторные передачи и другие маршруты. Не заменяй измерение пропускной способности результатами mtr.
6. Запиши исходные показатели при текущей подписке и меняй по одному параметру. Сохраняй одну и ту же подписку при сравнении минимального пути приёма с конвейером, включающим бизнес-обработку. Изменения фильтров проверяй отдельно. Перед сужением подписки сопоставь входные данные для решений с уведомлениями и проверь, что предлагаемые фильтры включают известные необходимые события. Спроектируй ограниченные очереди и параллелизм с сохранением требуемого порядка и полноты, явно задав поведение при переполнении. Не отбрасывай необходимые данные без разрешения. Сохраняй полные сведения об ошибках и о том, когда разрешена повторная попытка; не переподключайся в течение предписанной паузы.
7. Отдельно сообщи наблюдаемые факты, возможные причины, непроверенные гипотезы, изменения для проверки и измерения до/после. Оцени CPU, RAM, полосу, производительность хранения и размещение по подписке и измерениям, включая запас для пиков. Не придумывай универсальные фиксированные требования Solana к оборудованию. При необходимости предложи сравнение машин/дата-центров с одинаковыми подпиской, SDK и commitment.
Если я использую ERPC, прочитай актуальный gRPC FAQ и следуй инструкции для конкретного кода ошибки:
https://erpc.global/en/faq/grpc/general/
Если подключён ERPC User MCP или CLI, проверь реально доступные операции и права. Доступ к аккаунту не означает доступ к диагностике хоста. Перед созданием платного VPS, изменением договора, обновлением или перезапуском production покажи стоимость, цель и продолжительность теста и получи моё согласие. Сначала заверши диагностику и подготовь улучшения, которые можно проверить.Проверьте тот же код в сопоставимой среде
Измерения могут показать возможности улучшения ресурсов CPU, памяти или сетевого маршрута. Возможные варианты включают более мощный CPU, дополнительную память, разделение работы или размещение ближе к источнику. Связав эти решения с объёмом данных приложения и наблюдениями, проще понять, зачем их пробовать и какой эффект проверять.
ERPC VPS позволяет запускать потоковые клиенты рядом с инфраструктурой Solana. Почасовая оплата даёт возможность сравнить тот же код и подписку с текущей средой. Актуальные цены, регионы и наличие проверяйте в Dashboard. В ERPC требования к ресурсам также зависят от подписки и обработки в приложении.[7]
Сравнивайте не только скорость приёма, но и рост очереди, свежесть данных к завершению обработки, p99 и ошибки. Записывайте период измерения и нагрузку сети блокчейна. Одновременное сравнение или повторные измерения помогают не принять изменение трафика во времени за различие сред.
Для обращения в поддержку подготовьте настройки подписки без секретов, версию SDK, регион, временные метки, полные сообщения об ошибках и полученные результаты измерений. Значения, которые вы пока не получили, можно прямо обозначить как неизмеренные.
Каждое новое наблюдение облегчает выбор следующего изменения для проверки. Сохраняйте нужные данные и оценивайте улучшения шаг за шагом. Мы продолжим совершенствовать информацию и инфраструктуру, которые поддерживают вашу разработку.
Источники и полезные ссылки
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Спецификация подписок Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] Управление потоком HTTP/2: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Терминология Solana: https://solana.com/docs/references/terminology
- [6] Официальная документация mtr: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/ru/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- API измерений Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/ru/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/ru/
- Официальный Discord Validators DAO: https://discord.gg/C7ZQSrCkYR


