Десять мифов, замедляющих приложения Solana: почему быстрая инфраструктура не всегда дает быструю реакцию
Соединение быстрое. Процессор современный. Сервер находится в одном городе с поставщиком данных. И все же приложение медленно реагирует на нужную ему информацию. Соединение остается открытым, но обрабатываемые данные постепенно отстают все сильнее.
При разработке приложений с низкой задержкой на Solana у такой ситуации не всегда есть единственная причина. Маршрутизация, настройки приема, состав подписок и ожидание внутри приложения могут вместе мешать использовать выбранную быструю инфраструктуру в полной мере.
Команда поддержки ERPC, платформы под управлением ELSOUL LABO B.V., регулярно сталкивается с вопросами об остановившихся циклах приема, настройках клиентов, неоправданно широких подписках и повторных подключениях, не устраняющих исходную ошибку. Решения, почти не вызывавшие проблем в обычном веб-приложении, могут стать ограничениями для высокочастотной торговли и обработки в реальном времени.
В статье разбираются десять мифов, стоящих за такими проблемами. Она призвана помочь оценить и выбор инфраструктуры, и архитектуру, которая превращает ее производительность в своевременные решения и отправку транзакций.
Это руководство предназначено для разработчиков с опытом создания веб-приложений, которые начинают разрабатывать приложения для высокочастотной торговли (HFT) или других задач реального времени на Solana. В нем рассматриваются выбор среды и первые проверки. Подписка здесь означает выбор обновлений данных, которые приложение будет получать непрерывно.
Сначала определите, что должно завершаться раньше
Время сетевого обмена туда и обратно, момент поступления данных, время принятия решения и время до подтверждения транзакции представляют собой разные показатели. Быстрый ping не избавляет от медленных решений, если обработка останавливается после приема. Быстрый ответ RPC не обязательно означает, что транзакция выполнена.
Например, рассмотрим приложение, которое получает обновление состояния рынка, пересчитывает условия и отправляет транзакцию, когда они выполнены. Разделите время до поступления обновления, время завершения расчета и время проверки результата отправленной транзакции. Если определить, какой именно интервал нужно сократить, станет понятно, где искать причину задержки.
Далее отдельно измеряйте наблюдение, обработку после приема, отправку и подтверждение. Улучшение начинается с отказа сводить скорость к названию продукта или одному числу.
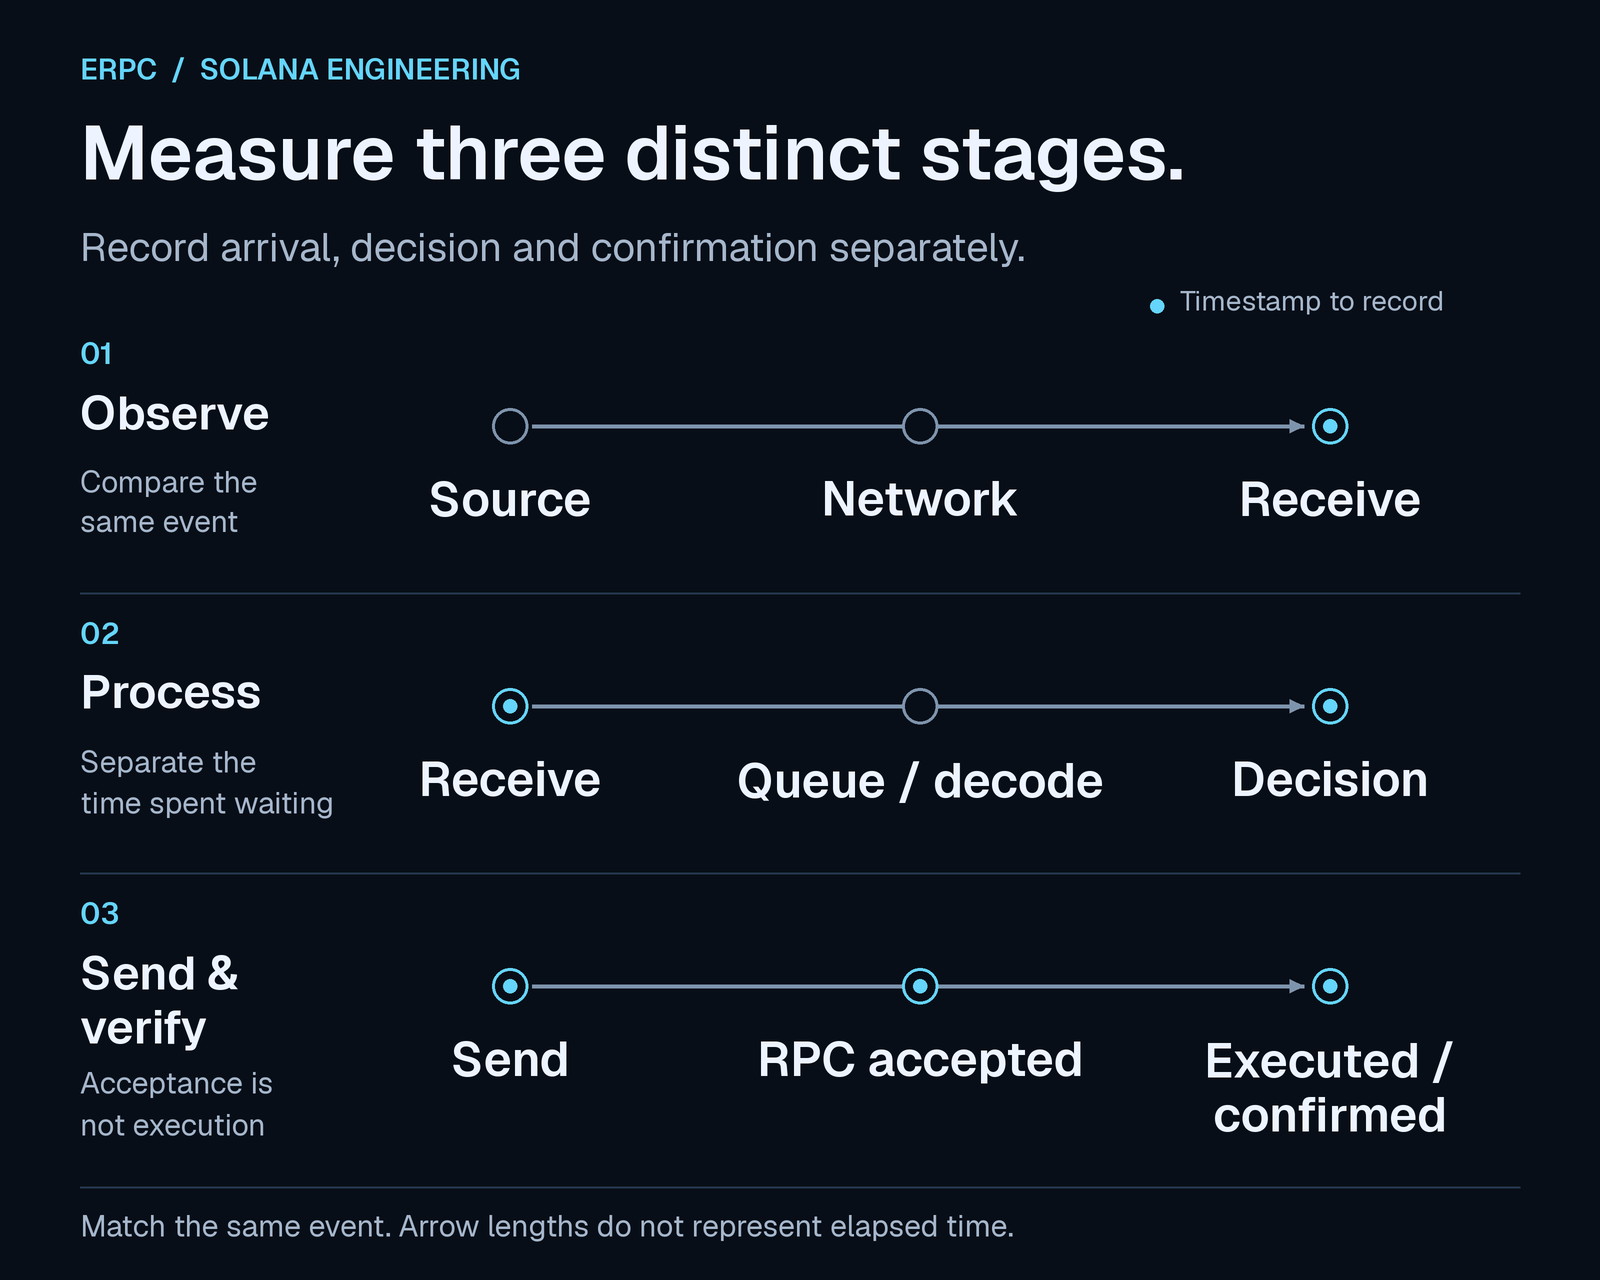
Отдельно измеряйте наблюдение, обработку внутри приложения, отправку и подтверждение. Диаграмма не отображает измеренные длительности или различия в производительности между этапами.
Миф 1: маленькая VM работает, значит, ресурсов достаточно
Небольшая облачная VM успешно справлялась с прежним веб-приложением или нагрузкой Ethereum. Такой опыт может подтолкнуть к мысли, что та же конфигурация справится и с потоком Solana. Но приложению, которое изредка делает RPC-запросы, и приложению, постоянно принимающему и обрабатывающему широкий набор обновлений, нужны разные ресурсы.
Подбирайте среду по объему данных, частоте их поступления, работе на одно событие и допустимой задержке. Сколько событий приходит в секунду? Сколько байтов передается? Сколько процессорного времени и памяти требуют декодирование и принятие решений? Предусмотрите запас для всплесков, а не только обычного трафика. Даже в одной блокчейн-сети требования меняются в зависимости от охвата подписок и реализации.
Сложность в том, что приложение с недостаточными ресурсами может выглядеть работающим. На экране продолжают появляться данные, но они становятся все менее актуальными, а пропуски при переподключении могут оставаться незамеченными. Один лишь счетчик полученных событий этого не покажет. Проверяйте число завершенных обработок, возраст необработанных данных и непрерывность событий, которые должна охватывать подписка.
Если единственным ориентиром остается прежний опыт, разработчик может вообще не усомниться в ресурсах принимающей стороны и продолжать винить источник данных. Проба среды с большим запасом способна обнаружить накопившуюся очередь или пропуски, которые раньше были незаметны.
Для проверки сравните работу с тем же endpoint, подпиской, уровнем commitment (запрашиваемой стадией подтверждения, о которой говорится в мифе 9), SDK, настройками и вычислительной нагрузкой в среде приема и обработки с большим запасом ресурсов. Сохраните регион, зафиксируйте различия в CPU, памяти и сети; сравните скорость приема, завершенную работу, очередь, пропущенные события и время до решения. Нагрузка меняется со временем, поэтому по возможности сравнивайте в один период, соблюдая ограничения на подключения и учитывая нагрузку на сервис.
Улучшение после смены среды показывает, что условия приема или обработки повлияли на результат. Если CPU, память и сеть изменились одновременно, нужны дополнительные проверки, чтобы определить значимый ресурс. Для низкой задержки необходимо подбирать ресурсы под фактический объем и темп данных.
Миф 2: один город означает близость в сети
«Оба сервера во Франкфурте, значит, они рядом». «Размещение в Токио должно быть самым быстрым для Японии». Названия городов помогают выбрать географию размещения, но не гарантируют реальный маршрут трафика.
Маршрут зависит от соединений между дата-центрами, связей между сетевыми операторами и решений маршрутизации. Даже серверы в одном городе могут обмениваться данными по обходному пути через внешние сети. Например, RIPE IPmap называет одним из своих применений визуализацию неэффективных маршрутов, когда трафик выходит из страны, а затем возвращается. [1]
Измеряйте RTT между фактическим источником данных и хостом приложения, его изменения во времени, повторные передачи или потери и время поступления одного и того же события. Traceroute и MTR помогают изучить путь, но число переходов само по себе не определяет качество маршрута. Также важно не принимать ограничение диагностических ответов промежуточного маршрутизатора за потерю пакетов, затрагивающую приложение.
После выбора региона задайте еще один вопрос: как именно соединены этот источник данных и этот сервер? Дополнительная проверка выявляет различия, которые нельзя узнать по одному названию города.
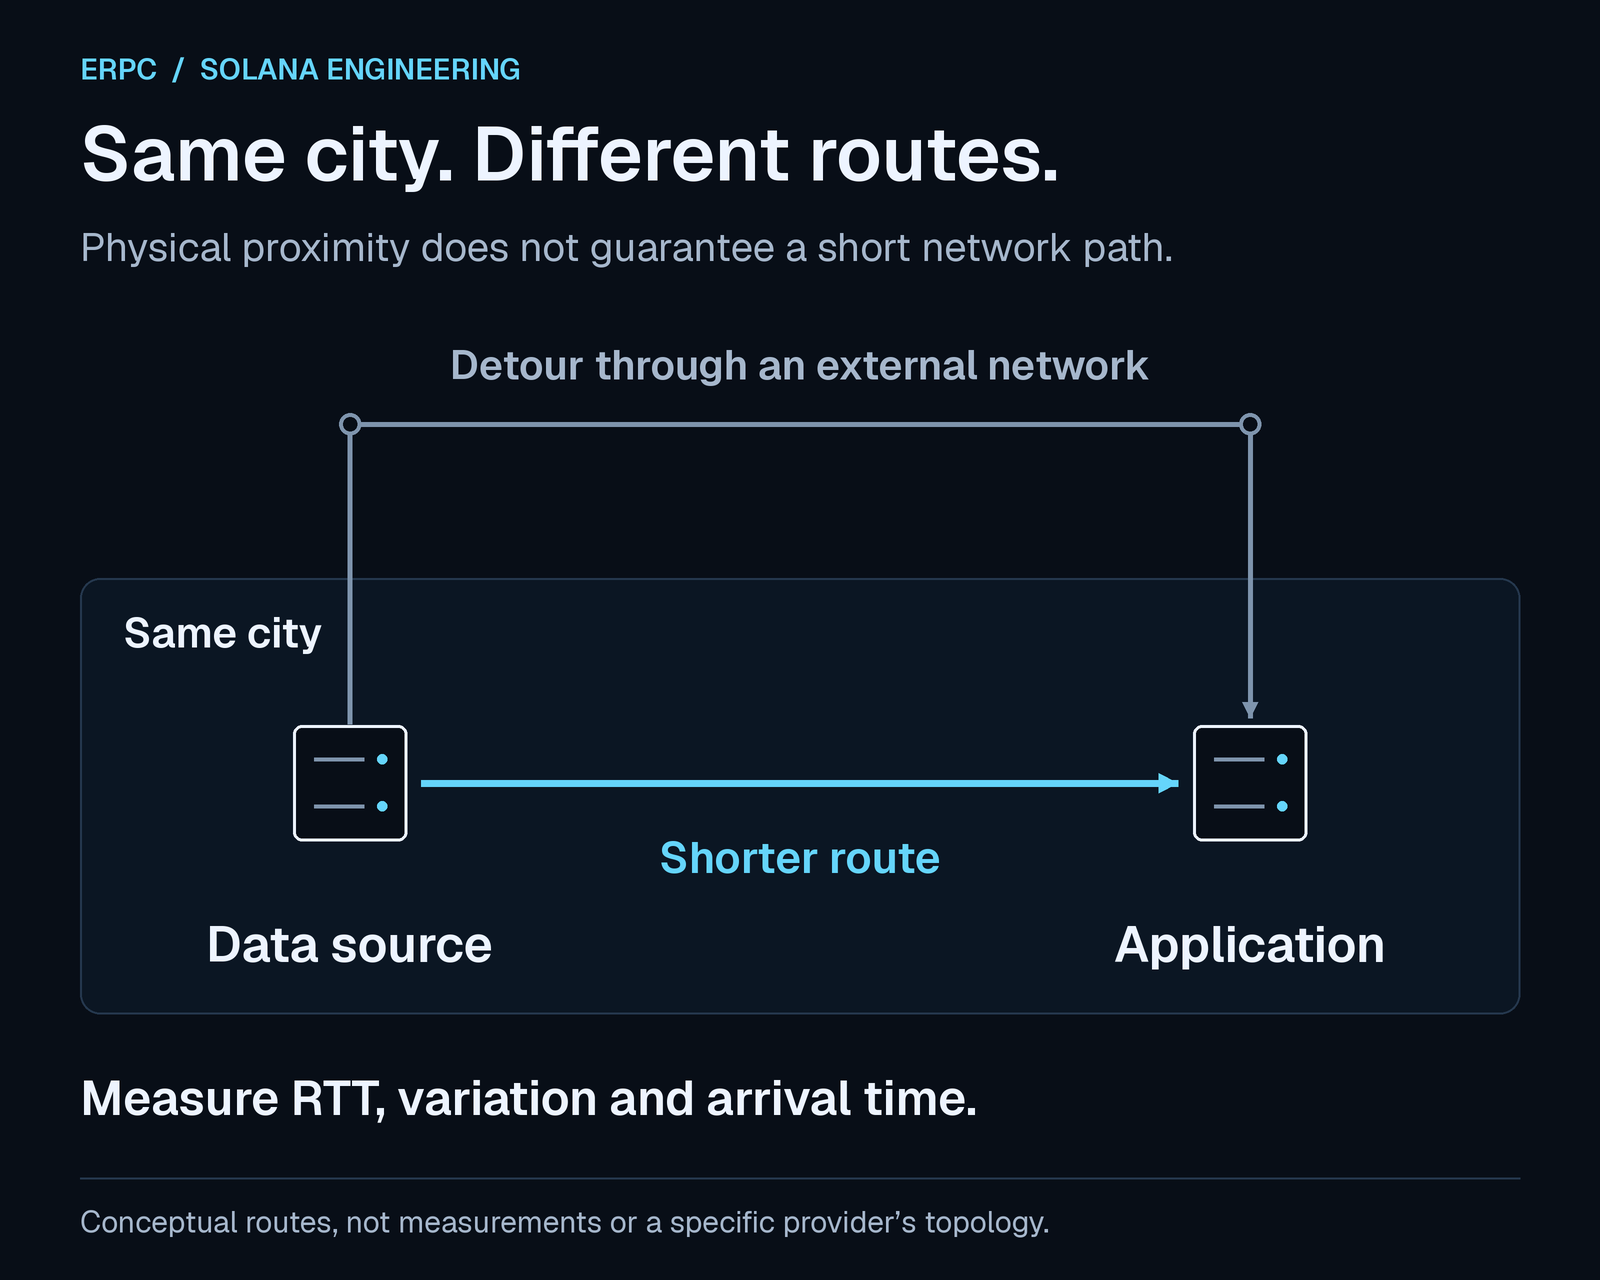
У двух серверов в одном городе могут различаться маршруты и время обмена туда и обратно. Диаграмма поясняет этот принцип и не изображает реальный маршрут какого-либо поставщика.
Миф 3: высокие сетевые характеристики гарантируют достаточную доступную полосу
Пропускная способность в спецификации сервера может означать разные вещи: скорость физического порта, полосу, выделенную виртуальной машине, устойчивую пропускную способность или временный предел для всплеска. Быстрая сетевая карта не означает, что приложение может постоянно использовать всю ее емкость.
Например, документация AWS различает базовую и кратковременно доступную пропускную способность и описывает ограничения, связанные с направлением трафика, потоками и количеством пакетов в секунду. Это пример чтения спецификаций, а не утверждение, что у всех VPS такие же ограничения, как у AWS. [2]
Выбирая тариф, выясните, выделенная полоса или общая, каковы условия длительной нагрузки и лимиты передачи, а также различаются ли правила для разных направлений трафика. Во время теста поддерживайте трафик к тому же endpoint с условиями подписки, планируемыми для эксплуатации, одновременно наблюдая за приемом, отброшенными пакетами, повторными передачами и нагрузкой CPU.
Высокий результат короткого теста скорости не доказывает, что сервер способен непрерывно обрабатывать рабочий поток. В то же время медленный прием не обязательно говорит о нехватке полосы. Прежде чем улучшать канал, отделите проблемы настроек приема от ограничений обработки.
Миф 4: более новая CPU, больше ядер или выше максимальные GHz ускоряют приложение
CPU не поддерживает максимальную частоту boost при любой нагрузке. Фактическая работа зависит от питания, температуры, прошивки, управления частотой и других задач. Документация Linux объясняет: включение boost разрешает его использование, но не показывает, что CPU действительно работает в этом режиме. [3]
Если важная работа сосредоточена в одном потоке, добавление ядер само по себе не ускорит ее завершение. Общая загрузка CPU может выглядеть низкой, пока одно ядро или цикл событий полностью заняты. Официальное руководство Node.js также объясняет, как тяжелая callback-функция заставляет другую работу ждать. [4]
Проверяйте частоту, температуру, загрузку отдельных ядер и время обработки под реальной нагрузкой. В виртуальной среде полезным показателем может быть и время ожидания выделения CPU. Профилируйте приложение, чтобы выяснить затраты на декодирование, вычисления, выделение памяти и логирование.
Выбирайте сочетание производительности CPU на нужной частоте, выделения ресурсов, настроек для устойчивой работы и реализации приложения. Сравнение одних названий процессоров не определит скорость всего приложения.
Миф 5: для gRPC достаточно стандартных настроек клиента
Установленное gRPC-соединение не доказывает, что оно способно принимать нужный объем данных с требуемой скоростью. В HTTP/2 есть управление потоком: получатель сообщает отправителю, сколько данных может принять. Оно действует на уровне отдельного потока и всего соединения, поэтому окна приема и их обновления могут ограничивать пропускную способность даже при свободной емкости сети. [5][6]
Окно приема указывает, сколько данных отправитель может передать до следующего обновления от получателя. Начальные значения, автоматическая адаптация и приоритет настроек отличаются между SDK и библиотеками. Большое число в конфигурационном файле не доказывает, что клиент ведет себя нужным образом. Проверяйте настройки потока и соединения, их взаимодействие с адаптивными параметрами и используемую версию.
Меняйте настройки, измеряя фактическую скорость приема и накопленную очередь обработки при одинаковых подписках. Максимальный размер принимаемого сообщения, буфер приема TCP и окно приема HTTP/2 представляют собой разные параметры. Keepalive проверяет жизнеспособность соединения, но не добавляет вычислительную мощность или полосу.
FAQ ERPC по gRPC содержит шаги диагностики и примеры конфигурации для потока, у которого скорость приема остается неизменной, а отставание растет. Используйте примеры как отправную точку, затем проверяйте их применительно к своему объему подписок и мощности обработки. Прежде чем использовать пример конфигурации, запишите название и версию SDK. Найдите, где в этом SDK задаются окна приема на уровне потока и соединения и их автоматическая настройка, затем сопоставьте эти параметры с примером из FAQ. Если вы используете другой SDK, проверьте соответствующие настройки в его документации, а не переносите названия параметров и значения без изменений. [7]
Миф 6: прием всех полных блоков позволяет принимать решения раньше
«Сначала получим все, потом найдем нужное». Это понятный старт разработки, но он добавляет работу, которая может быть не нужна до принятия решения. Передача, декодирование, выделение памяти и поиск ненужных данных расходуют конечные ресурсы сети и CPU.
Если нужно реагировать на изменения конкретного рынка, программы или аккаунта, сначала определите события и поля, необходимые для решения. Yellowstone gRPC предлагает фильтры подписок на транзакции и аккаунты, а также способ получать лишь часть данных аккаунта. Уведомления о полных блоках и уведомления об отдельных обновлениях тоже не одно и то же. [8]
Для требования «пересчитывать условия при каждом изменении рынка A» перечислите информацию, которая определяет рынок A, состояние, используемое в расчете, и события, обновляющие это состояние. Нужные данные зависят от спецификации программы, поэтому сопоставьте ее с получаемыми обновлениями. По этому списку сузьте подписки, затем проверьте, что состояние, необходимое для решения, остается полным.
При одинаковых ресурсах и условиях, если одно приложение ждет распаковки и поиска по всем записям, а другое сразу обрабатывает нужное обновление, второе избегает этого ожидания. Более сфокусированный конкурент может регулярно реагировать раньше по причинам, выходящим за пределы сетевого соединения. При проектировании низкой задержки важно определить, что можно игнорировать.
Индексация, аудит, исследования и историческое хранение вполне обоснованно могут требовать всех данных. Выделите для этой нагрузки отдельный путь. Отделение ее от немедленных решений позволяет спроектировать нужную мощность и полноту каждого пути. Однако проверьте, что фильтры не убрали обновления, необходимые для корректных решений. Пакетная обработка в некоторых случаях повышает суммарную производительность, поэтому выбирайте ее с учетом допустимого ожидания.
В текущем Shared gRPC ERPC непустая подписка
blocks требует сервиса Dedicated. Подписки transactions или blocksMeta могут решить отдельную задачу, но ни одна не предоставляет те же данные, что полные блоки. Выбор Dedicated по-прежнему требует достаточной обработки на принимающей стороне и продуманного состава подписок. [9]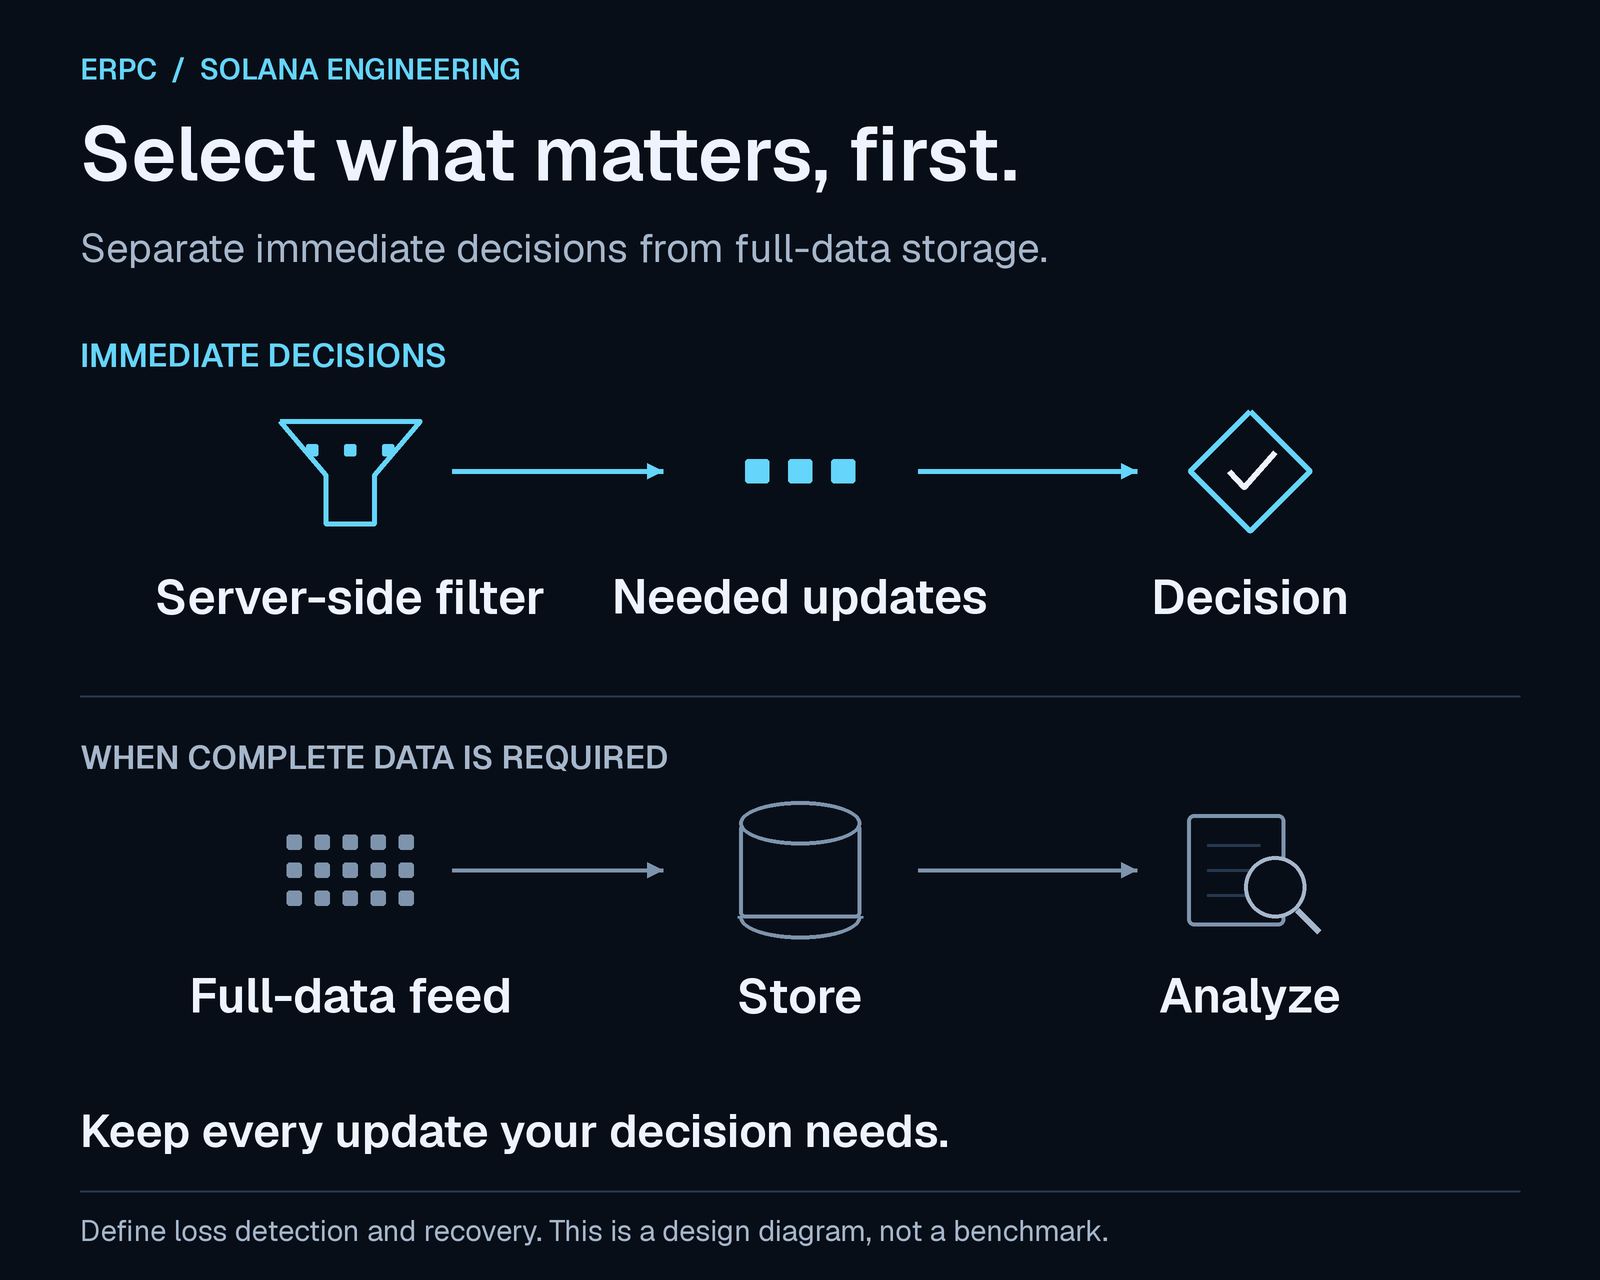
Используйте один путь для обновлений, необходимых для немедленных решений, и другой для полного хранения и анализа. Диаграмма показывает архитектурный подход. Проверьте, что фильтрация сохраняет состояние, необходимое для правильных решений, и определите способ восстановления пропущенных данных.
Миф 7: если данные поступают, обработка успевает
Между приемом данных и их обработкой до состояния, пригодного для решения, может образоваться очередь. Если входящая работа постоянно превышает возможности обработки, задержка накапливается даже при открытом соединении. Большой буфер способен поглотить временный всплеск, но при устойчивой нехватке производительности он лишь хранит больше старых данных.
Рассмотрим условный пример, в котором сначала нет необработанных событий. Приложение получает 12 000 событий одного вида в секунду и завершает обработку 10 000 событий в секунду. Если оно может сохранять каждое событие в очереди, ничего не отбрасывая и не объединяя, число необработанных событий увеличивается на 2 000 в секунду и через 10 секунд достигает 20 000. Соединение остается активным, данные продолжают появляться, но работа, необходимая для решений, отстает. Эти числа объясняют механизм и не являются результатами измерения производительности ERPC.
Измеряйте не только число полученных событий. Измеряйте завершенную обработку, длину очереди, возраст самого старого необработанного элемента и время от приема до завершения решения. Отдельно следите за состоянием соединения и актуальностью данных.
Оставляйте в цикле приема только работу, необходимую для продолжения приема. Рассмотрите перенос записей в базу, логирования полных сообщений, внешних API-вызовов и тяжелых вычислений в другие пути обработки. Ограничьте емкость очередей и определите поведение при заполнении. Даже ограниченная очередь после заполнения может заставить предыдущие этапы ждать; сама по себе она не устраняет нехватку мощности обработки. [10]
Для обновлений, где важно только последнее состояние, иногда можно объединять старые состояния. События транзакций, которым нужна упорядоченная или полная обработка, нельзя отбрасывать без разбора. Спроектируйте обнаружение пропусков, повторное воспроизведение и восстановление состояния после переподключения согласно требованиям приложения.
STREAM_GUARD_SLOW_READER в ERPC представляет собой защитную реакцию на недостаточный прогресс записи или наблюдаемое отставание доставки. Не устанавливайте причину только по этому признаку. Проверьте соединение, хост, объем подписок и скорость потребления данных приложением. До переподключения сохраните первые status, message, metadata и trailers, если они доступны, а затем изучите причину и условия повтора, предоставленные сервером. Повторная отправка той же отклоненной заявки без исправления оставляет причину на месте. [7]Миф 8: быстрый ping или хорошее среднее означают скорость в нужный момент
Ping дает ориентир по времени сетевого обмена туда и обратно. Это другой интервал, чем задержка приложения, которая включает обработку у источника, состав подписки, ожидание приема, декодирование и решение. Среднее также может скрывать небольшое число значительных задержек.
p50 обозначает медиану. p95 и p99 обозначают значения, на уровне которых или ниже находятся соответственно 95% и 99% измерений. p99 не является максимумом. Указывайте число наблюдений и период измерения, проверяйте показатели при всплесках событий, максимумы, тайм-ауты, разрывы соединения и пропущенные данные. [11]
Сравнивая поставщиков, сопоставляйте одно событие, тип данных, commitment и условия подписки. По возможности принимайте данные на одном измерительном хосте и используйте монотонные часы для длительностей внутри приложения. Вычитая временные метки разных хостов, учитывайте расхождение часов, способное исказить результат.
Если оставлять только успешные события, конфигурация с частыми пропусками может выглядеть быстрой. Выбор самого быстрого единичного результата и выбор конфигурации, которая с меньшей вероятностью отстанет в нужный для эксплуатации момент, представляют собой разные решения.
Миф 9: самые ранние данные имеют ту же степень подтверждения и означают то же самое
Shreds, уведомления о транзакциях, обновления аккаунтов и уведомления о блоках представляют разную информацию на разных этапах. Использование более ранних данных может оставлять приложению больше работы по восстановлению или интерпретации. Для сравнения нужно согласовать не только время приема, но и то, что можно узнать к этому моменту. [8][12]
Различайте и уровни commitment Solana:
processed, confirmed и finalized. Если решения основаны на ранних наблюдениях, приложение должно позже проверить их подтверждение и при необходимости исправить свое состояние. Отделяйте получение раннего обновления от условий окончательного действия во внешней системе. [13]Например, простое сравнение уведомлений с разным commitment и заявление, что одно быстрее на определенное число миллисекунд, не сравнивает одинаковую работу. Определите, какие данные и какой уровень подтверждения нужны приложению, затем измерьте, сколько времени требуется для готовности к решению при этих условиях.
Миф 10: успешная отправка означает, что транзакция выполнится первой
Успешный ответ
sendTransaction означает, что RPC принял транзакцию. Это не гарантирует обработку или подтверждение кластером. Спецификация Solana прямо требует отдельно проверять статус подписи. [14]Даже если входящие данные позволяют принять раннее решение, важны путь отправки, срок действия blockhash, конкуренция за записываемые аккаунты, вычислительные ресурсы, комиссии приоритета и условия успешности самой транзакции. SWQoS касается допуска и приоритета соединений к лидеру, а комиссии приоритета влияют на приоритет планирования. Их роли различны, и ни один механизм не гарантирует безусловно порядок исполнения или успех. [15][16]
Отдельно фиксируйте завершение решения, начало отправки, прием RPC, результат выполнения и требуемое состояние подтверждения. При повторе различайте повторную отправку транзакции с той же подписью и создание новой транзакции, чтобы избегать непреднамеренного дублирования действий.
Только наблюдая весь путь от приема до подтверждения, можно определить, какое улучшение приблизит к цели.
Какие измерения наладить сначала
Начните с трех проверок.
- Выберите одно решение и запишите, какие обновления для него нужны и какое состояние должно быть доступно, прежде чем приложение сможет принять решение.
- За один и тот же период измерения фиксируйте число полученных событий, событий с завершенной обработкой и необработанных событий одного вида. Если работа ожидает в очереди, измеряйте также время с момента, когда приложение получило самое старое необработанное событие.
- Если число необработанных событий или время ожидания непрерывно растет, найдите, где накапливается работа. Выберите одно соответствующее симптомам изменение в подписках, обработке, настройках или среде выполнения и сравните результаты до и после.
Время с момента приема приложением показывает ожидание внутри приложения. Задержку от исходного события до его приема приложением измеряйте отдельно. Когда первые записи будут готовы, используйте следующую таблицу, чтобы расширить проверки.
| Этап | Что записывать | Что помогает обнаружить |
|---|---|---|
| Сеть и прием | Фактическую скорость приема, повторные передачи и потери, разницу прихода одного события | Ограничения маршрута, полосы и настроек приема |
| Приложение | Число полученных и обработанных событий, длину очереди, возраст старейшего элемента | Постоянный дефицит обработки и накопление устаревших данных |
| Время до решения | p50, p95, p99 и максимум от приема до завершения решения | Дорогую обработку и задержки при всплесках |
| Отправка и подтверждение | Начало отправки, прием RPC, статус подписи, ошибки выполнения | Задержки и сбои после приема |
| Условия сравнения | Регион, хост, SDK и версию, подписку, commitment, период и число наблюдений | Кажущиеся различия из-за разных условий |
Сохраните базовый результат, затем проверяйте по одному изменению в зависимости от симптомов: охват подписки, разделение обработки, настройки клиента, размещение или ресурсы. Расширяя окно, проверяйте рост памяти и очереди. Сужая подписку, проверяйте сохранность необходимой информации.
p99 общего времени не вычисляется простым сложением p99 отдельных этапов. Рассчитывайте его из полного времени каждого сопоставленного события, а измерения этапов используйте для поиска причин. Проверяйте работу не только при средней нагрузке, но и во время реальных всплесков событий.
ERPC готовит инфраструктуру, чтобы разработчики совершенствовали логику
Когда сети, серверы, доставка данных и клиенты выбираются отдельно, между ними может сохраняться ожидание, даже если характеристики каждого хороши. ERPC объединяет доставку данных Solana и среды обработки на одной платформе, сокращая повторяющуюся работу по выбору размещения и ресурсов с нуля.
SUPER VPS и Premium VPS предусматривают высокочастотные конфигурации и выделение ресурсов без overcommitment, а Bare Metal предоставляет физически выделенную машину. ERPC приближает сети и серверы к среде доставки и подготавливает CPU, память, хранилище и соединения для непрерывной обработки. Конкретные характеристики доступны для каждого тарифа и региона. [17][18]
| Частая сложность разработки | Инфраструктура и информация ERPC | Что улучшать в приложении |
|---|---|---|
| Расстояние, невидимое по названиям городов | Региональные и сетевые конфигурации для совместного выбора доставки и обработки | Измерять поступление данных и его вариации при своих подписках |
| Конкуренция за ресурсы и длительная производительность | Высокочастотные SUPER VPS и Premium VPS без overcommitment и выделенный Bare Metal | Находить дорогие операции и последовательную обработку |
| Объем данных и способ подключения | gRPC, Shreds, RPC, общие и выделенные варианты под нагрузку | Определять необходимые события и поля |
| Настройки приема и диагностика | Solana Stream SDK, примеры конфигурации, документация фильтров и FAQ по ошибкам | Проверять действующие настройки, очереди, переподключение и восстановление |
ERPC помогает продвинуться в выборе и настройке инфраструктуры, оставляя больше времени на определение того, что наблюдать, на каких данных принимать решения и когда отправлять транзакции. При подходящем сервисе и размещении согласование объема подписки с возможностями обработки превращает производительность инфраструктуры в скорость приложения.
Начните с информации, действительно необходимой для решений. Получайте ее раньше, обрабатывайте без лишнего ожидания и проверяйте результат. ERPC продолжит предоставлять среду и информацию для таких улучшений.
Ресурсы для реализации
- FAQ ERPC по gRPC: https://erpc.global/ru/faq/grpc/general/
- Фильтры подписок и текущие ограничения Shared: https://erpc.global/ru/doc/geyser-grpc/filter/
- Рекомендации по реализации gRPC: https://erpc.global/ru/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/ru/vps/
- ERPC Bare Metal: https://erpc.global/ru/baremetal/
- Панель ERPC: https://dashboard.erpc.global/
- Официальный Discord Validators DAO: https://discord.gg/C7ZQSrCkYR
Технические источники
- RIPE IPmap, визуализация неэффективной маршрутизации: https://ipmap.ripe.net/
- AWS, пропускная способность сети экземпляров: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, предотвращение блокировки цикла событий: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, управление потоком HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, настройки приема, медленные читатели и повторы в FAQ gRPC: https://erpc.global/ru/faq/grpc/general/
- Yellowstone gRPC, спецификации подписок и фильтров: https://github.com/rpcpool/yellowstone-grpc
- ERPC, текущие правила фильтров Shared: https://erpc.global/ru/doc/geyser-grpc/filter/
- Tokio, очереди и обратное давление: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, определения процентилей: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/ru/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, комиссии транзакций: https://solana.com/docs/core/fees
- ERPC, конфигурации и характеристики VPS: https://erpc.global/ru/vps/
- ERPC, конфигурации и характеристики Bare Metal: https://erpc.global/ru/baremetal/