Maak je Solana-app sneller: bekijk gRPC-datavolume, ontvangstverwerking en systeembronnen
De Solana-applicatie die je bouwt, kan mogelijk sneller werken. De hoeveelheid ontvangen gegevens, de verwerking daarna en middelen zoals CPU en netwerk werken samen. Door die combinatie te bekijken, kun je mogelijk meer prestaties uit je bestaande software halen.
Je bent begonnen met het bouwen van HFT op Solana, hebt verbinding gemaakt met Geyser gRPC en ziet gegevens in de logs. Toch komen beslissingen niet zo snel als je verwachtte. Wachttijd tussen ontvangst en een beslissing kan aanwijzingen geven voor verbetering. Begin met het vinden van de plaatsen die je in je huidige code kunt observeren.
Bij ERPC bieden gesprekken en feedback van klanten ons de gelegenheid om de gegevenslevering, ontvangstinstellingen en verwerking in applicaties te bekijken. Die inzichten gebruiken we om onze levering en documentatie te verbeteren. Dit artikel legt de werking en onderzoeksstappen uit, zodat ontwikkelaars die voor het eerst snelle datastromen met een groot volume verwerken, verbeteringen in hun eigen omgeving kunnen onderzoeken.
Begin met één kleine controle in je huidige code
Technische termen en diagnoseopdrachten kun je opzoeken zodra ze van pas komen. Als je een AI-agent hebt die de code van je project kan lezen, probeer dan eerst de korte vraag hieronder. Voeg toe waar de applicatie draait en wanneer deze traag aanvoelt. Onbesliste vereisten en ontbrekende meetwaarden mogen zo blijven terwijl je begint.
text
Ik wil onderzoeken of mijn Solana-applicatie sneller kan reageren.
Lees eerst de huidige code en wijs aan waar gegevens worden ontvangen en waar de beslissing die deze gegevens gebruikt, wordt afgerond. Houd het abonnement ongewijzigd en stel de kleinste wijziging voor waarmee aantallen events en verstreken tijd over dat traject kunnen worden gemeten.
Laat voor deze eerste taak de meetpunten, de voorgestelde wijziging, de mogelijke inzichten en de nog niet gemeten delen zien. Als toegang tot de host ontbreekt, begin dan met wat binnen de applicatie waarneembaar is. Toon geen vertrouwelijke gegevens, wijzig de productieomgeving niet en maak geen betaalde resources aan.
Ik wil onderzoeken of mijn Solana-applicatie sneller kan reageren.
Lees eerst de huidige code en wijs aan waar gegevens worden ontvangen en waar de beslissing die deze gegevens gebruikt, wordt afgerond. Houd het abonnement ongewijzigd en stel de kleinste wijziging voor waarmee aantallen events en verstreken tijd over dat traject kunnen worden gemeten.
Laat voor deze eerste taak de meetpunten, de voorgestelde wijziging, de mogelijke inzichten en de nog niet gemeten delen zien. Als toegang tot de host ontbreekt, begin dan met wat binnen de applicatie waarneembaar is. Toon geen vertrouwelijke gegevens, wijzig de productieomgeving niet en maak geen betaalde resources aan.Het eerste bruikbare resultaat is weten waar en wat je in je eigen code kunt meten. Door waarneembare en nog niet gemeten trajecten te onderscheiden, kun je gemakkelijker kiezen wat je daarna onderzoekt. Verderop in het artikel staat een uitgebreidere prompt voor verdere diagnose.
Een agent zou bijvoorbeeld kunnen antwoorden: ‘De ontvangst vindt plaats in
stream.ts bij onData; de beslissing wordt afgerond in strategy.ts bij onDecisionComplete. Ik stel een wijziging voor die de aantallen ontvangen events en afgeronde beslissingen en de verstreken tijd over dit traject aggregeert. Het traject vóór de callback valt buiten de reikwijdte van dit meetvoorstel.’ Dit voorbeeld gebruikt fictieve bestands- en functienamen in TypeScript. Controleer, ongeacht de programmeertaal, of deze drie zaken op elkaar aansluiten: de locaties in de werkelijke code, de toe te voegen meetgegevens en de grenzen van deze meting. Als ontvangst en beslissingen geen een-op-eenrelatie hebben, vraag de agent dan ook om hun koppeling en de teleenheid voor te stellen.Voeg een kijk op datastromen toe aan je ervaring met webontwikkeling
Met beheerde diensten kunnen ontwikkelaars veel webfuncties bouwen zonder stil te staan bij afzonderlijke serveronderdelen. Die ervaring blijft een basis voor het werken met Solana-streams. Voeg daar een beeld aan toe van hoeveel gegevens er voortdurend binnenkomen en hoe snel de applicatie ze verwerkt.
Een SDK met Solana verbinden kan net zo eenvoudig lijken. Maar een abonnement op een breed scala aan transacties of accountupdates verandert de werklast. De benodigde bandbreedte, CPU en het geheugen hangen af van het abonnement, de berichtgrootte, compressie, verwerking in de applicatie en het verkeer op dat moment. Er bestaat geen vast aantal megabytes per seconde voor ‘Solana’.
Het begint ermee dat je de verhouding tussen binnenkomend werk en verwerkingscapaciteit bewust meeneemt in je ontwerp en metingen.
Ook een actieve stream kan een wachtrij opbouwen
Vergelijk eerst de gegevens die binnen dezelfde seconde aankomen, met tegels van gelijke grootte. Elke tegel staat voor 1.000 berichten; bij een aangenomen grootte van 1 kB per bericht is dat samen 1 MB. In het kleinere voorbeeld komt 2 MB per seconde binnen en in het grotere 12 MB per seconde. De ontvangende app heeft in beide gevallen dezelfde verwerkingscapaciteit. Dit is een illustratief model van het volume aan berichtinhoud in decimale eenheden, zonder compressie en protocolheaders.
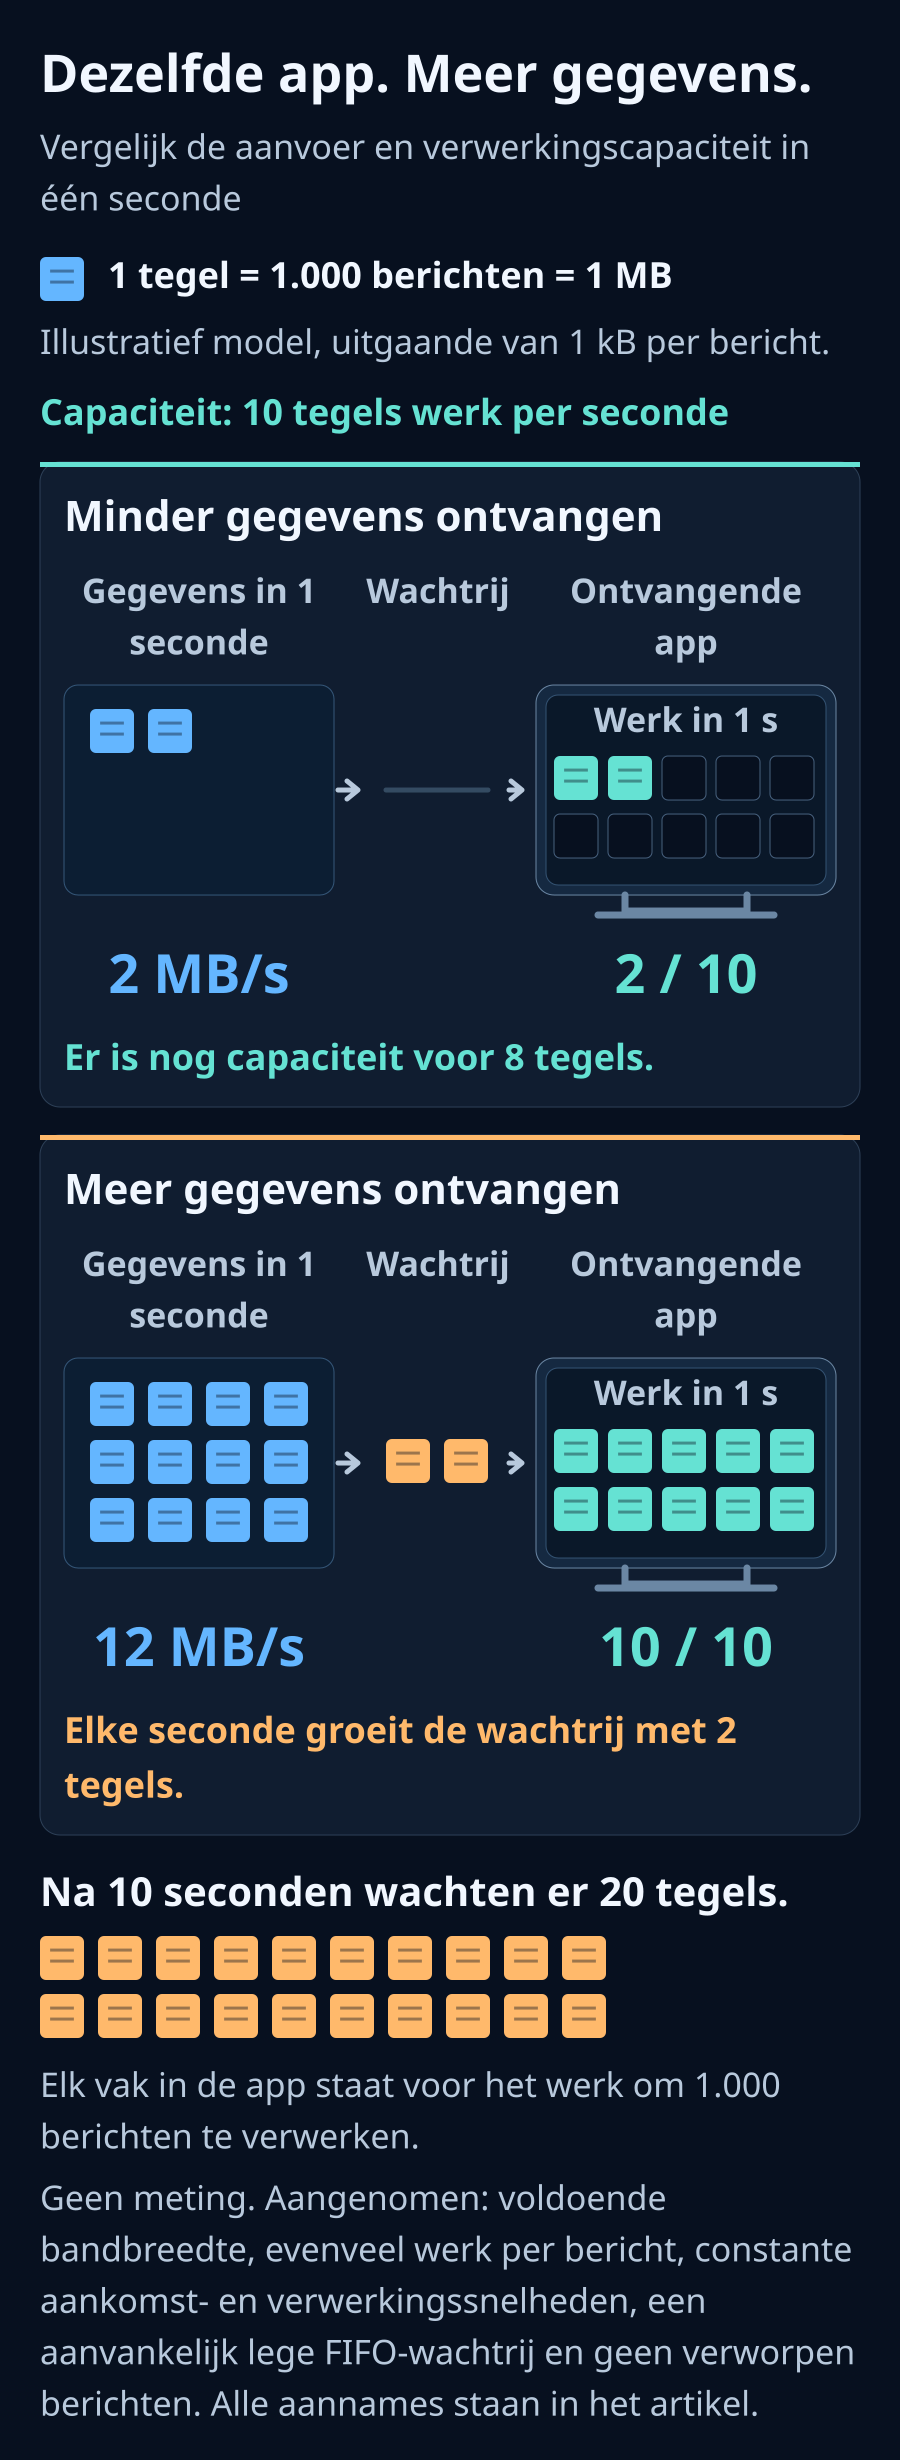
Neem een vereenvoudigd model: er komen 12.000 gebeurtenissen per seconde binnen, en een computer kan er 10.000 per seconde verwerken. Elke gebeurtenis vraagt evenveel werk, de wachtrij is aanvankelijk leeg, de verwerking volgt de volgorde van binnenkomst en er worden geen gebeurtenissen weggegooid.
Elke seconde blijven nog eens 2.000 gebeurtenissen onverwerkt. Na tien seconden staan er 20.000 te wachten. Een gebeurtenis die op dat moment achteraan aansluit, wacht ongeveer twee seconden voordat de verwerking begint. De logs blijven doorlopen terwijl de wachtrij blijft groeien.
Dit zijn aannames ter verduidelijking, geen metingen van Solana of ERPC. Het model gaat uit van een constante instroom en capaciteit. In werkelijkheid komt verkeer in pieken binnen en verschillen de verwerkingskosten, waardoor wachttijd ook kan ontstaan als de gemiddelde capaciteit voldoende is.
De flow control van gRPC stemt de verzending af op wat de ontvanger kan aannemen. Als de verwerking achterloopt, kan de wachttijd zich buiten de applicatiewachtrij uitbreiden naar communicatiebibliotheken of de verzender. Een actieve verbinding of een geslaagde schrijfactie naar een verzend-API toont niet aan hoe actueel de gegevens bij aankomst zijn.[1]
Kies de gegevens die je nodig hebt voordat ze het netwerk overgaan
Als je beslissingen alleen informatie over bepaalde programma’s of accounts nodig hebben, bepaal dan eerst welke gegevens dat zijn en pas abonnementsfilters aan de serverkant toe. Yellowstone gRPC ondersteunt filters voor transacties en accounts. Controleer de precieze combinaties en beschikbare mogelijkheden in de specificaties van de API, SDK en dienst die je gebruikt.[2]
Weet je nog niet wat je moet filteren, bekijk dan de code om vast te stellen welke waarden je applicatie voor beslissingen gebruikt en welke velden in de meldingen die leveren. Leid daar mogelijke filtervoorwaarden voor je abonnement uit af en controleer vervolgens of bekende benodigde events zijn opgenomen. Door zowel de afname van het aantal events als het behoud van de benodigde gegevens te controleren, leg je een goede basis voor de volgende vergelijking.
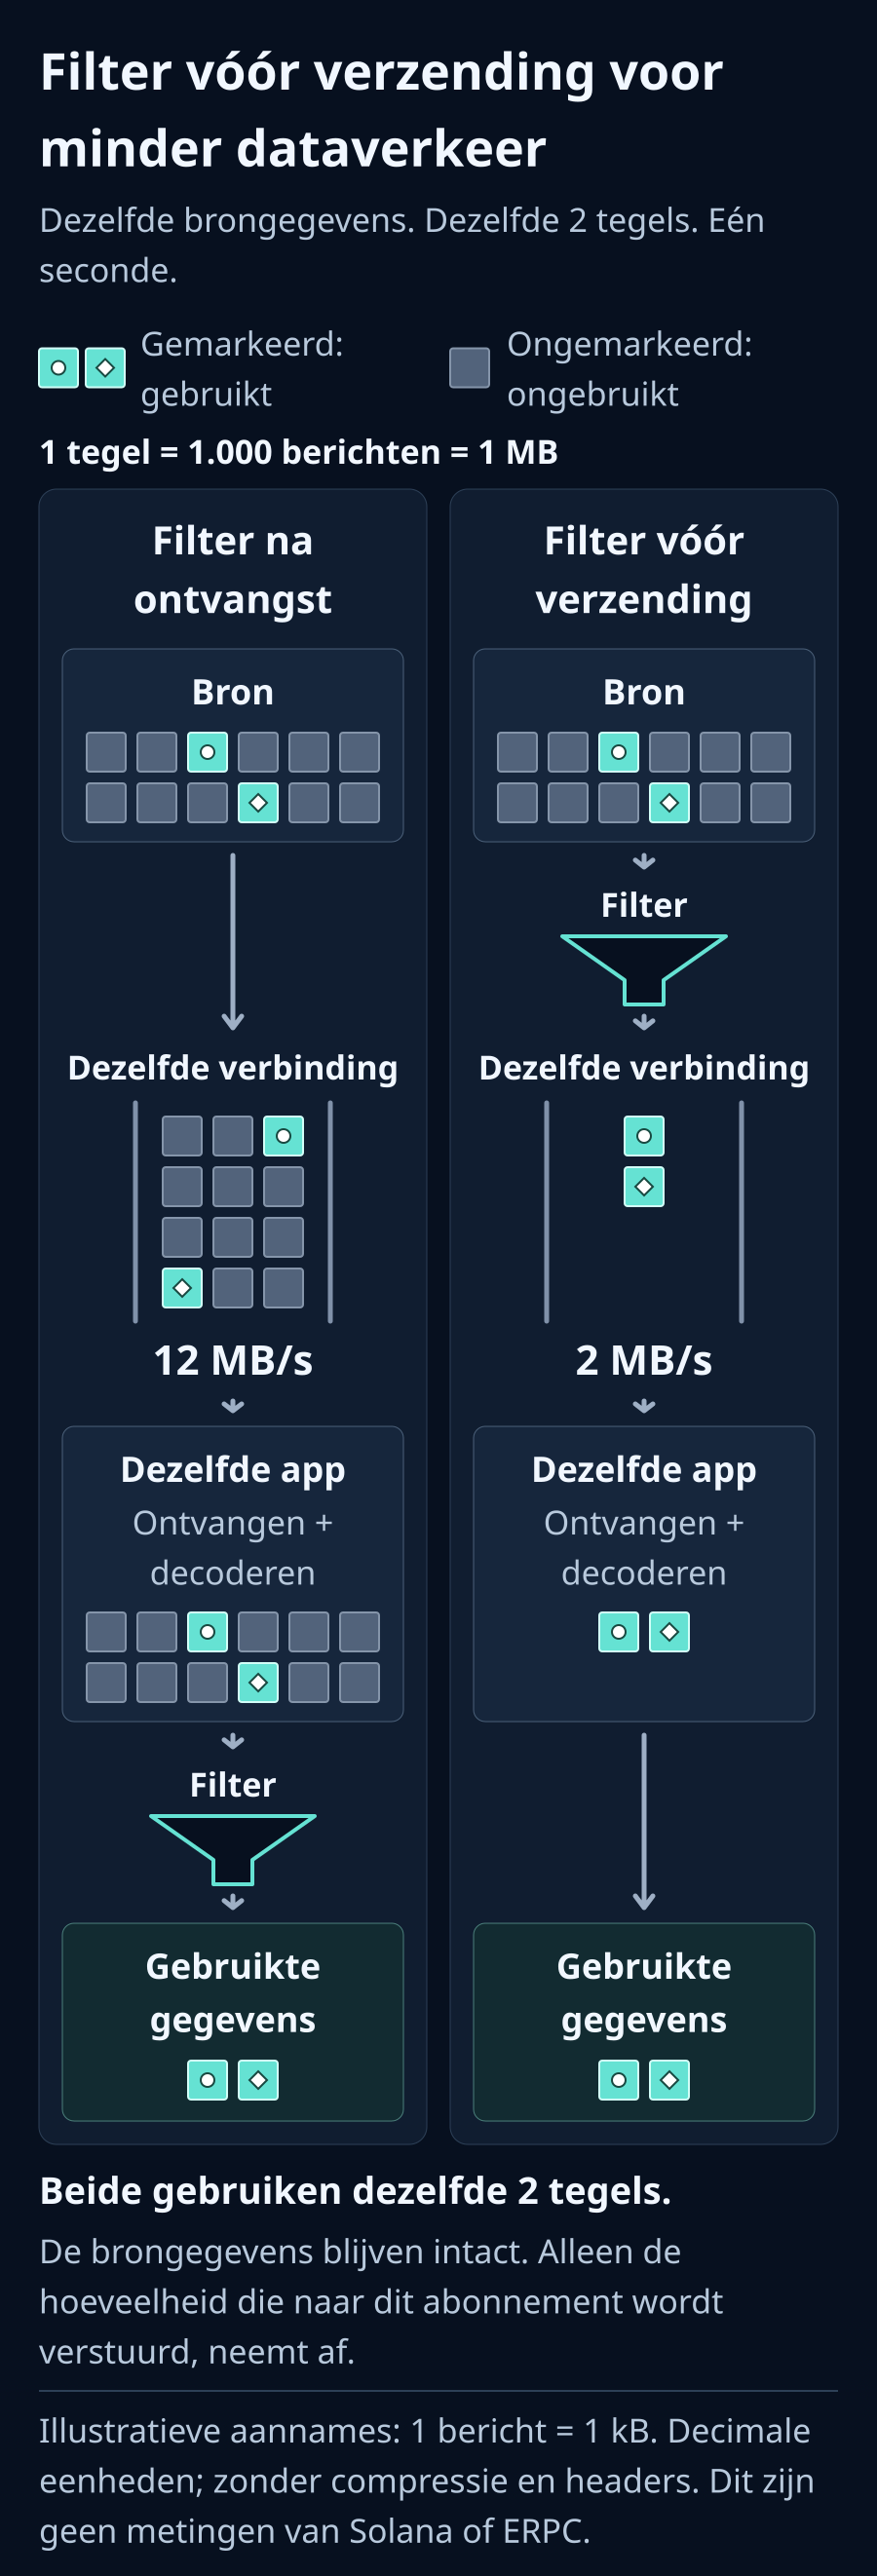
Alles ontvangen en ongewenste gegevens pas in de client weggooien, laat de kosten voor overdracht, ontsleuteling en decodering tot dat punt bestaan. Filteren bij de verzender kan dat werk verminderen. Als je in het bovenstaande voorbeeld de instroom beperkt tot de benodigde 2.000 gebeurtenissen per seconde, heeft dezelfde verwerkingscapaciteit van 10.000 gebeurtenissen per seconde voldoende ruimte.
Denk aan verkeer: de weglengte stelt de overdrachtsafstand voor, rijstroken staan voor bandbreedte, het tolhuisje voor verwerkingscapaciteit bij ontvangst en de rij auto’s voor wachtend werk. Alleen de benodigde auto’s door hetzelfde tolhuisje sturen levert een andere wachtrij op dan alle auto’s uit de omgeving ernaartoe leiden. De weg verkorten en het aantal auto’s verminderen zijn afzonderlijke verbeteringen.
Communicatie heeft ook fysieke grenzen. Het overdragen van 100 MB met 1 Gbps duurt theoretisch minstens 0,8 seconde; met 10 Gbps is dat 0,08 seconde. Dit zijn ondergrenzen op basis van decimale eenheden, zonder afstand, protocoloverhead, hertransmissies en wachtend werk. Het betekent niet dat elke afzonderlijke gebeurtenis in een stream 0,8 seconde vertraging heeft.
Zelfs als één berekening sneller gaat dan een netwerkuitwisseling, blijft het versturen van onnodige gegevens werk kosten. Bekijk de voortplantingstijd van het signaal, hoeveel er per tijdseenheid over de verbinding kan en hoeveel werk na aankomst kan worden afgerond afzonderlijk.
Sommige toepassingen hebben alle gegevens nodig, zoals volledige indexen, audits en onderzoek. Daarvoor is ontvangst-, verwerkings- en opslagcapaciteit nodig die bij die werklast past. Alle afzonderlijke meldingen ontvangen is bovendien iets anders dan wachten op een volledig blok: gegevens die tot een blok zijn samengevoegd en gereconstrueerd. Controleer of je beslissing onnodig afhangt van niet-relevante gegevens of van het afronden van die samenvoeging.[2]
Bekijk de verwerking bij ontvangst en de systeembronnen
Rust kan helpen de verwerkingskosten te verlagen. Bekijk, om die snelheid te benutten, ook het inkomende volume, de effectieve verbindingscapaciteit, wachttijd bij het schrijven naar databases, locks en seriële delen. In een asynchrone runtime kan het ook de applicatie verbeteren als CPU-intensief werk en werk dat een thread blokkeert op geschikte plaatsen in het systeem worden uitgevoerd.[3]
Houd de ontvangstlus kort en voer zwaar werk apart uit. Bepaal een limiet voor de wachtrij en wat er gebeurt als die vol is. Een onbeperkte wachtrij kan groeiende vertraging verbergen als toenemend geheugengebruik. Een begrensde wachtrij lost een aanhoudend tekort aan verwerkingscapaciteit evenmin op. Bewaar de vereiste volgorde en volledigheid terwijl je kiest tussen kleinere abonnementen, efficiëntere verwerking, opsplitsing, parallelle verwerking en extra middelen.
Begin met het meten van ontvangst tot het afronden van de beslissing en onderzoek daarna waar wachttijd optreedt. De onderstaande tabel biedt een eerste manier om naar elk onderdeel te kijken. Uitgebreide namen van meetwaarden en opdrachten staan ook in de diagnoseprompt verderop, zodat je de relevante punten kunt gebruiken.
| Onderdeel | Wat je eerst kunt controleren |
|---|---|
| CPU | Komt het werk op één core terecht? Bekijk het totale gebruik en het gebruik per core, samen met CPU-limieten in de uitvoeringsomgeving |
| Geheugen | Blijven het aantal wachtende events of het geheugengebruik groeien? Bekijk de hoeveelheid gegevens in de wachtrij samen met de wachttijd van het oudste event |
| Schijf en database | Wacht de ontvangst tot opslag is afgerond? Controleer databasewrites en wachttijd bij opslag. Als de applicatie geen gegevens bewaart, bieden andere onderdelen een startpunt |
| Netwerk | Passen de verbinding en de instellingen bij het inkomende volume? Controleer de werkelijke overdrachtssnelheid, de retourtijd en hertransmissies |
Wanneer je de communicatie verder onderzoekt, kunnen bibliotheekinstellingen extra aanwijzingen geven. HTTP/2 heeft flow-controlvensters op zowel stream- als verbindingsniveau, die bepalen hoeveel extra gegevens de andere kant mag versturen. Als die ruimte klein is ten opzichte van het bandbreedte-vertragingsproduct, oftewel bandbreedte vermenigvuldigd met retourtijd, kan de doorvoer een plafond bereiken terwijl de verbinding nog ruimte heeft. Controleer in zo’n geval de bibliotheek en tussenliggende onderdelen en let bij het aanpassen op het toepassingsbereik en het geheugengebruik van de instelling.[4]
Meet naast ontvangst ook actualiteit en wachttijd
Om te beginnen met het onderzoeken van achterstand binnen de applicatie, behoud je het huidige abonnement en registreer je over dezelfde observatieperiode ontvangen gebeurtenissen, afgeronde gebeurtenissen, het aantal in de wachtrij en de wachttijd van de oudste gebeurtenis. Weet je niet waar je moet meten, laat een agent dan met de prompt verderop de code onderzoeken. Is er geen expliciete wachtrij, begin dan met de tijd van ontvangst tot het afronden van de beslissing en vergelijk die met een diagnoseversie waarin zware verwerking is weggelaten.
De volgende pseudocode, onafhankelijk van taal en SDK, laat zien waar de metingen thuishoren. Behoud de huidige verwerkingsvolgorde en gelijktijdigheid wanneer je meetinstrumentatie aan de werkelijke code toevoegt.
text
Wanneer gegevens worden ontvangen:
  Verhoog het aantal ontvangen events met 1
  Leg een monotone ontvangsttijd vast die aan dat event gekoppeld is
  Geef het event door aan de bestaande verwerking

Wanneer de beslissing op basis van hetzelfde event is afgerond:
  Verhoog het aantal afgeronde events met 1
  Bereken en aggregeer de verstreken tijd sinds de ontvangst
Wanneer gegevens worden ontvangen:
Verhoog het aantal ontvangen events met 1
Leg een monotone ontvangsttijd vast die aan dat event gekoppeld is
Geef het event door aan de bestaande verwerking
Wanneer de beslissing op basis van hetzelfde event is afgerond:
Verhoog het aantal afgeronde events met 1
Bereken en aggregeer de verstreken tijd sinds de ontvangstAls ontvangst en beslissingen geen een-op-eenrelatie hebben, bepaal dan eerst die koppeling en de eenheid die je telt. Door waarnemingen over een vast interval samen te vatten, kun je resultaten vergelijken zonder voor elk event een extra logbericht toe te voegen.
Registreer voor verdere diagnose ook ontvangen bytes, bytes in de wachtrij, p50/p95/p99 van de verwerkingstijd, fouten en herverbindingen. De p99 is de grens waar 99% van de gemeten verwerkingstijden op of onder ligt. Vermeld waar elke meting plaatsvindt. Verkeer op de netwerkkaart, Protobuf-grootte en de omvang van gedecodeerde objecten zijn verschillende grootheden.
Gebruik een monotone klok voor verstreken tijd binnen één host en meet ontvangst, plaatsing in de wachtrij, ophalen uit de wachtrij en afronding afzonderlijk. Als het decoderen al klaar is zodra een SDK-callback wordt aangeroepen, is de periode vóór die callback niet gemeten. Controleer bij vergelijking met een tijdstempel van de verzender de kloksynchronisatie en de plaats waar dat tijdstempel is gemaakt. Noem het verschil niet automatisch zuivere netwerklatentie.
Als de wachttijd afneemt wanneer je de applicatieverwerking weglaat zonder het abonnement te veranderen, is dat een aanwijzing om het effect van die verwerking te onderzoeken. Snelle verwerking na de callback bewijst op zichzelf niet dat de gegevens actueel aankwamen.
Je kunt gebeurtenis-ID’s ook vergelijken met een referentiestream met hetzelfde abonnement en commitment, oftewel de bevestigingsfase van de gegevens die je gebruikt. Controleer daarbij dat de referentiestream zelf geen achterstand opbouwt. Een gat tussen slotnummers bewijst op zichzelf geen gegevensverlies en is niet om te rekenen naar een vast aantal seconden: sommige slots bevatten geen passende gebeurtenis en slots kunnen worden overgeslagen.[5]
mtr helpt om vertragingen en antwoordpatronen op een route te onderzoeken. Verlies bij alleen een tussenliggende hop kan betekenen dat een router zijn antwoorden beperkt. Vergelijk het gedrag tot aan de bestemming met TCP-hertransmissies, effectieve overdrachtssnelheden en een andere route. mtr alleen kan geen uitgeputte bandbreedte of storing in een datacenter aantonen.[6]
Een diagnoseprompt voor je AI-agent
Geef de volgende tekst aan een agent die de code van je project kan lezen. Vertel eerst waar het draait en wanneer en op welke manier het traag aanvoelt. De agent kan eerst de verbinding, het abonnement en de verwerking na ontvangst uit de code onderzoeken. Je hoeft geen API-sleutels of inloggegevens in het gesprek te plakken.
Als de benodigde gebeurtenissen of de aanvaardbare vertraging nog niet zijn bepaald, zeg dan dat ze nog openstaan. Leg in je eigen woorden uit welke informatie je wilt volgen en welke beslissingen je wilt nemen. Behandel niet-beschikbare metingen als niet gemeten en begin met wat je nu kunt onderzoeken.
text
Onderzoek of mijn Solana Geyser gRPC-client sneller kan reageren. Als er vertraging, een achterstand of verbroken verbindingen zijn, isoleer dan de oorzaken en help deze te verbeteren. Leid niet alleen uit een geslaagde verbinding of events in de logs af dat actuele gegevens worden verwerkt. Bepaal niet vooraf of de oorzaak bij de client of de aanbieder ligt.

1. Stel het doel vast: benodigde gebeurtenissen, aanvaardbare actualiteit, eisen voor volgorde en gegevensverlies, abonnementsfilters, commitment, regio van het eindpunt, werkelijke versies van taal/SDK/gRPC-bibliotheek en uitvoeromgeving. Onderzoek eerst beschikbare code, configuratie en lockfiles; vraag alleen naar ontbrekende informatie. Laat nog niet bepaalde eisen uitdrukkelijk openstaan en onderzoek eerst de huidige situatie. Toon geen geheimen en scherm gevoelige informatie in gedeelde logs af.

2. Meet van ontvangst tot afronding. Geef prioriteit aan ontvangst, afronding en wachttijden en begin met wat meetbaar is. Registreer gebeurtenissen/seconde, bytes/seconde, afgeronde gebeurtenissen/seconde, aantal/bytes in de wachtrij en wachttijd van de oudste gebeurtenis, p50/p95/p99, fouten, verbroken verbindingen, herverbindingen en drops. Als er geen expliciete wachtrij is, vermeld dat dan en bepaal welke verwerkingsintervallen je kunt waarnemen. Vermeld meetpunten en niet-gemeten perioden. Maak onderscheid tussen verkeer op de netwerkkaart, bytes op de verbinding, Protobuf-grootte en gedecodeerde objecten. Gebruik een monotone klok voor lokaal verstreken tijd; controleer voor externe tijden de synchronisatie en oorsprong van het tijdstempel. Vertaal een gat tussen slotnummers niet rechtstreeks naar gegevensverlies of een vaste duur.

3. Scheid beperkingen van CPU, geheugen, schijf en netwerk. Onderzoek CPU per core/thread, steal en CPU-limieten, RSS/GC/swap/PSI, I/O-wachttijd, bytes/drops/fouten van de netwerkkaart, TCP-hertransmissies en RTT. Mogelijke Linux-hulpmiddelen zijn mpstat, pidstat, vmstat, iostat, sar, ss -ti en /proc/pressure/. Meld het als hulpmiddelen of rechten ontbreken en geef de minimaal benodigde opdrachten. Als toegang tot de host ontbreekt, zoek dan naar informatie in de beheerconsole of applicatie-instrumentatie en markeer niet-beschikbare grootheden als niet gemeten. Verzin nooit resultaten.

4. Onderzoek HTTP/2-vensters op stream- en verbindingsniveau, TCP-ontvangstbuffers, proxy’s, VPN’s en sidecars. Raadpleeg officiële documentatie voor de geïnstalleerde SDK-versie en bekijk het bandbreedte-vertragingsproduct. Controleer JSON-conversie, loggen per gebeurtenis, synchrone databaseaanroepen of aanroepen van externe API’s, blokkerend werk, locks, onbeperkte taakaanmaak en onbeperkte wachtrijen in of rond de ontvangstlus. Beschouw Rust of asynchrone code alleen niet als een oplossing.

5. Als mtr of een vergelijkbaar hulpmiddel beschikbaar is, voer dan een begrensde meting uit naar de werkelijke host van het eindpunt. Overweeg op ondersteunde systemen: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Gebruik de werkelijke poort in plaats van een standaard TLS-poort aan te nemen. Bestempel verlies bij alleen een tussenliggende hop niet als een storing; vergelijk het gedrag op de bestemming, hertransmissies en andere routes. Gebruik mtr niet als vervanging voor een bandbreedtemeting.

6. Leg een nulmeting vast met het huidige abonnement en wijzig steeds één variabele. Behoud hetzelfde abonnement wanneer je een minimaal ontvangstpad vergelijkt met de pipeline inclusief applicatieverwerking. Behandel filterwijzigingen als een afzonderlijke vergelijking. Koppel de invoergegevens voor beslissingen aan de bijbehorende meldingen voordat je het abonnement beperkt, en controleer of kandidaatfilters bekende benodigde gebeurtenissen bevatten. Ontwerp begrensde wachtrijen en parallelle verwerking die de vereiste volgorde en volledigheid behouden en leg vast wat er gebeurt als de wachtrij vol is. Gooi benodigde gegevens niet ongemerkt weg. Bewaar volledige foutdetails en de voorgeschreven momenten voor nieuwe pogingen; maak tijdens een opgelegde pauze niet opnieuw verbinding.

7. Rapporteer waargenomen feiten, mogelijke oorzaken, niet-getoetste hypotheses, controleerbare wijzigingen en metingen vóór en na de wijziging afzonderlijk. Schat CPU, RAM, bandbreedte, opslagprestaties en locatie op basis van het abonnement en de metingen, met ruimte voor pieken. Verzin geen vaste universele hardware-eis voor Solana. Stel zo nodig een vergelijking tussen machines of datacenters voor met hetzelfde abonnement, SDK en commitment.

Als ik ERPC gebruik, lees dan de actuele gRPC-FAQ en volg de instructies voor de precieze foutcode:
https://erpc.global/en/faq/grpc/general/
Als ERPC User MCP of een CLI is verbonden, controleer dan welke handelingen en rechten werkelijk beschikbaar zijn. Toegang tot accountgegevens betekent niet dat hostdiagnoses mogelijk zijn. Presenteer kosten, doel en testduur en vraag mijn toestemming voordat je een betaalde VPS aanmaakt, een contract wijzigt, productie bijwerkt of herstart. Rond eerst de diagnose en controleerbare verbeteringen af.
Onderzoek of mijn Solana Geyser gRPC-client sneller kan reageren. Als er vertraging, een achterstand of verbroken verbindingen zijn, isoleer dan de oorzaken en help deze te verbeteren. Leid niet alleen uit een geslaagde verbinding of events in de logs af dat actuele gegevens worden verwerkt. Bepaal niet vooraf of de oorzaak bij de client of de aanbieder ligt.
1. Stel het doel vast: benodigde gebeurtenissen, aanvaardbare actualiteit, eisen voor volgorde en gegevensverlies, abonnementsfilters, commitment, regio van het eindpunt, werkelijke versies van taal/SDK/gRPC-bibliotheek en uitvoeromgeving. Onderzoek eerst beschikbare code, configuratie en lockfiles; vraag alleen naar ontbrekende informatie. Laat nog niet bepaalde eisen uitdrukkelijk openstaan en onderzoek eerst de huidige situatie. Toon geen geheimen en scherm gevoelige informatie in gedeelde logs af.
2. Meet van ontvangst tot afronding. Geef prioriteit aan ontvangst, afronding en wachttijden en begin met wat meetbaar is. Registreer gebeurtenissen/seconde, bytes/seconde, afgeronde gebeurtenissen/seconde, aantal/bytes in de wachtrij en wachttijd van de oudste gebeurtenis, p50/p95/p99, fouten, verbroken verbindingen, herverbindingen en drops. Als er geen expliciete wachtrij is, vermeld dat dan en bepaal welke verwerkingsintervallen je kunt waarnemen. Vermeld meetpunten en niet-gemeten perioden. Maak onderscheid tussen verkeer op de netwerkkaart, bytes op de verbinding, Protobuf-grootte en gedecodeerde objecten. Gebruik een monotone klok voor lokaal verstreken tijd; controleer voor externe tijden de synchronisatie en oorsprong van het tijdstempel. Vertaal een gat tussen slotnummers niet rechtstreeks naar gegevensverlies of een vaste duur.
3. Scheid beperkingen van CPU, geheugen, schijf en netwerk. Onderzoek CPU per core/thread, steal en CPU-limieten, RSS/GC/swap/PSI, I/O-wachttijd, bytes/drops/fouten van de netwerkkaart, TCP-hertransmissies en RTT. Mogelijke Linux-hulpmiddelen zijn mpstat, pidstat, vmstat, iostat, sar, ss -ti en /proc/pressure/. Meld het als hulpmiddelen of rechten ontbreken en geef de minimaal benodigde opdrachten. Als toegang tot de host ontbreekt, zoek dan naar informatie in de beheerconsole of applicatie-instrumentatie en markeer niet-beschikbare grootheden als niet gemeten. Verzin nooit resultaten.
4. Onderzoek HTTP/2-vensters op stream- en verbindingsniveau, TCP-ontvangstbuffers, proxy’s, VPN’s en sidecars. Raadpleeg officiële documentatie voor de geïnstalleerde SDK-versie en bekijk het bandbreedte-vertragingsproduct. Controleer JSON-conversie, loggen per gebeurtenis, synchrone databaseaanroepen of aanroepen van externe API’s, blokkerend werk, locks, onbeperkte taakaanmaak en onbeperkte wachtrijen in of rond de ontvangstlus. Beschouw Rust of asynchrone code alleen niet als een oplossing.
5. Als mtr of een vergelijkbaar hulpmiddel beschikbaar is, voer dan een begrensde meting uit naar de werkelijke host van het eindpunt. Overweeg op ondersteunde systemen: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Gebruik de werkelijke poort in plaats van een standaard TLS-poort aan te nemen. Bestempel verlies bij alleen een tussenliggende hop niet als een storing; vergelijk het gedrag op de bestemming, hertransmissies en andere routes. Gebruik mtr niet als vervanging voor een bandbreedtemeting.
6. Leg een nulmeting vast met het huidige abonnement en wijzig steeds één variabele. Behoud hetzelfde abonnement wanneer je een minimaal ontvangstpad vergelijkt met de pipeline inclusief applicatieverwerking. Behandel filterwijzigingen als een afzonderlijke vergelijking. Koppel de invoergegevens voor beslissingen aan de bijbehorende meldingen voordat je het abonnement beperkt, en controleer of kandidaatfilters bekende benodigde gebeurtenissen bevatten. Ontwerp begrensde wachtrijen en parallelle verwerking die de vereiste volgorde en volledigheid behouden en leg vast wat er gebeurt als de wachtrij vol is. Gooi benodigde gegevens niet ongemerkt weg. Bewaar volledige foutdetails en de voorgeschreven momenten voor nieuwe pogingen; maak tijdens een opgelegde pauze niet opnieuw verbinding.
7. Rapporteer waargenomen feiten, mogelijke oorzaken, niet-getoetste hypotheses, controleerbare wijzigingen en metingen vóór en na de wijziging afzonderlijk. Schat CPU, RAM, bandbreedte, opslagprestaties en locatie op basis van het abonnement en de metingen, met ruimte voor pieken. Verzin geen vaste universele hardware-eis voor Solana. Stel zo nodig een vergelijking tussen machines of datacenters voor met hetzelfde abonnement, SDK en commitment.
Als ik ERPC gebruik, lees dan de actuele gRPC-FAQ en volg de instructies voor de precieze foutcode:
https://erpc.global/en/faq/grpc/general/
Als ERPC User MCP of een CLI is verbonden, controleer dan welke handelingen en rechten werkelijk beschikbaar zijn. Toegang tot accountgegevens betekent niet dat hostdiagnoses mogelijk zijn. Presenteer kosten, doel en testduur en vraag mijn toestemming voordat je een betaalde VPS aanmaakt, een contract wijzigt, productie bijwerkt of herstart. Rond eerst de diagnose en controleerbare verbeteringen af.Test dezelfde code in een vergelijkbare omgeving
Metingen kunnen mogelijkheden blootleggen om CPU- of geheugenresources of het netwerkpad te verbeteren. Een krachtigere CPU, meer geheugen, opgesplitst werk of een locatie dichter bij de bron zijn mogelijke opties. Door die keuzes te verbinden aan het datavolume van je applicatie en je waarnemingen, worden zowel de reden om ze te proberen als het te controleren effect duidelijker.
ERPC VPS is een mogelijkheid om streamclients dicht bij Solana-infrastructuur te draaien. Met afrekening per uur kun je dezelfde code en hetzelfde abonnement vergelijken met je huidige omgeving. Controleer actuele prijzen, regio’s en beschikbaarheid in het Dashboard. Ook bij ERPC hangt de benodigde capaciteit af van je abonnement en de verwerking in je applicatie.[7]
Vergelijk naast ontvangstdoorvoer ook de groei van de wachtrij, de actualiteit bij het afronden van de verwerking, p99 en fouten. Noteer de meetperiode en de belasting van de blockchain. Gelijktijdige vergelijkingen of herhaalde metingen helpen voorkomen dat veranderingen in verkeer door de tijd worden aangezien voor verschillen tussen omgevingen.
Deel voor ondersteuning je abonnementsinstellingen met afgeschermde gevoelige informatie, SDK-versie, regio, tijdstippen, volledige foutmeldingen en de meetresultaten die je al hebt. Waarden die je nog niet hebt verkregen, mag je als niet gemeten aangeven.
Elke extra waarneming maakt het gemakkelijker om de volgende wijziging te kiezen. Behoud de gegevens die je nodig hebt en controleer verbeteringen stap voor stap. Wij blijven de informatie en infrastructuur verbeteren die jouw ontwikkeling ondersteunen.
Bronnen en gerelateerde links
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Abonnementsspecificatie van Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] HTTP/2-flow control: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Solana-terminologie: https://solana.com/docs/references/terminology
- [6] Officiële mtr-documentatie: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/nl/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- Meet-API’s van Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/nl/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/nl/
- Officiële Discord van Validators DAO: https://discord.gg/C7ZQSrCkYR


